
GPT2.5 Image
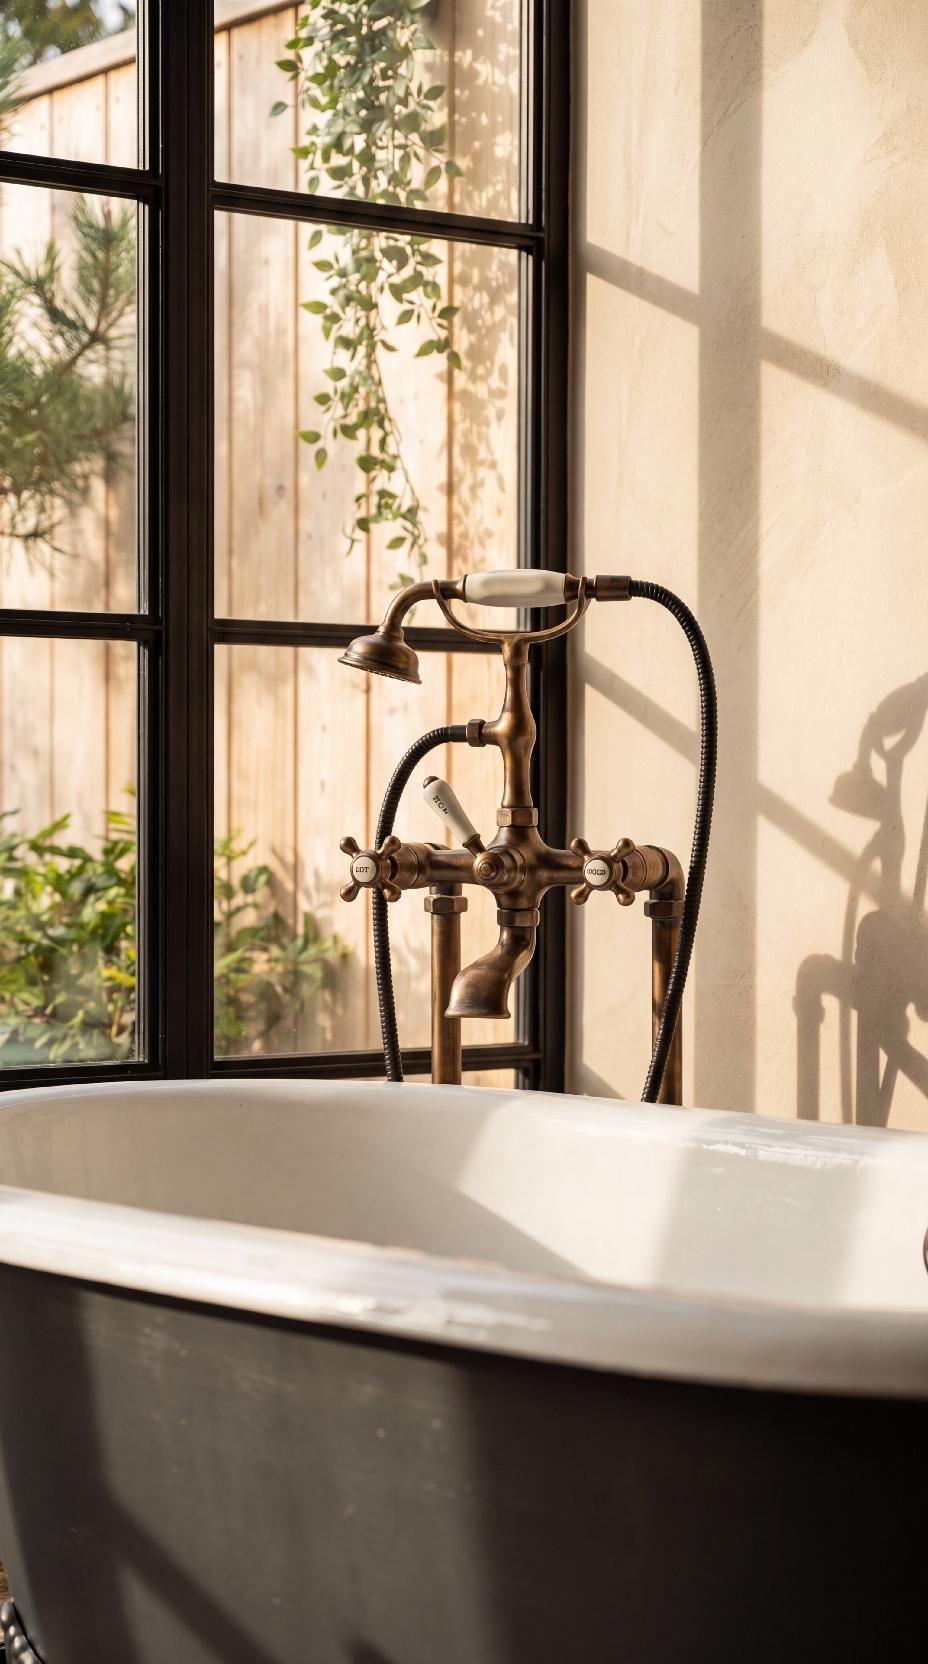
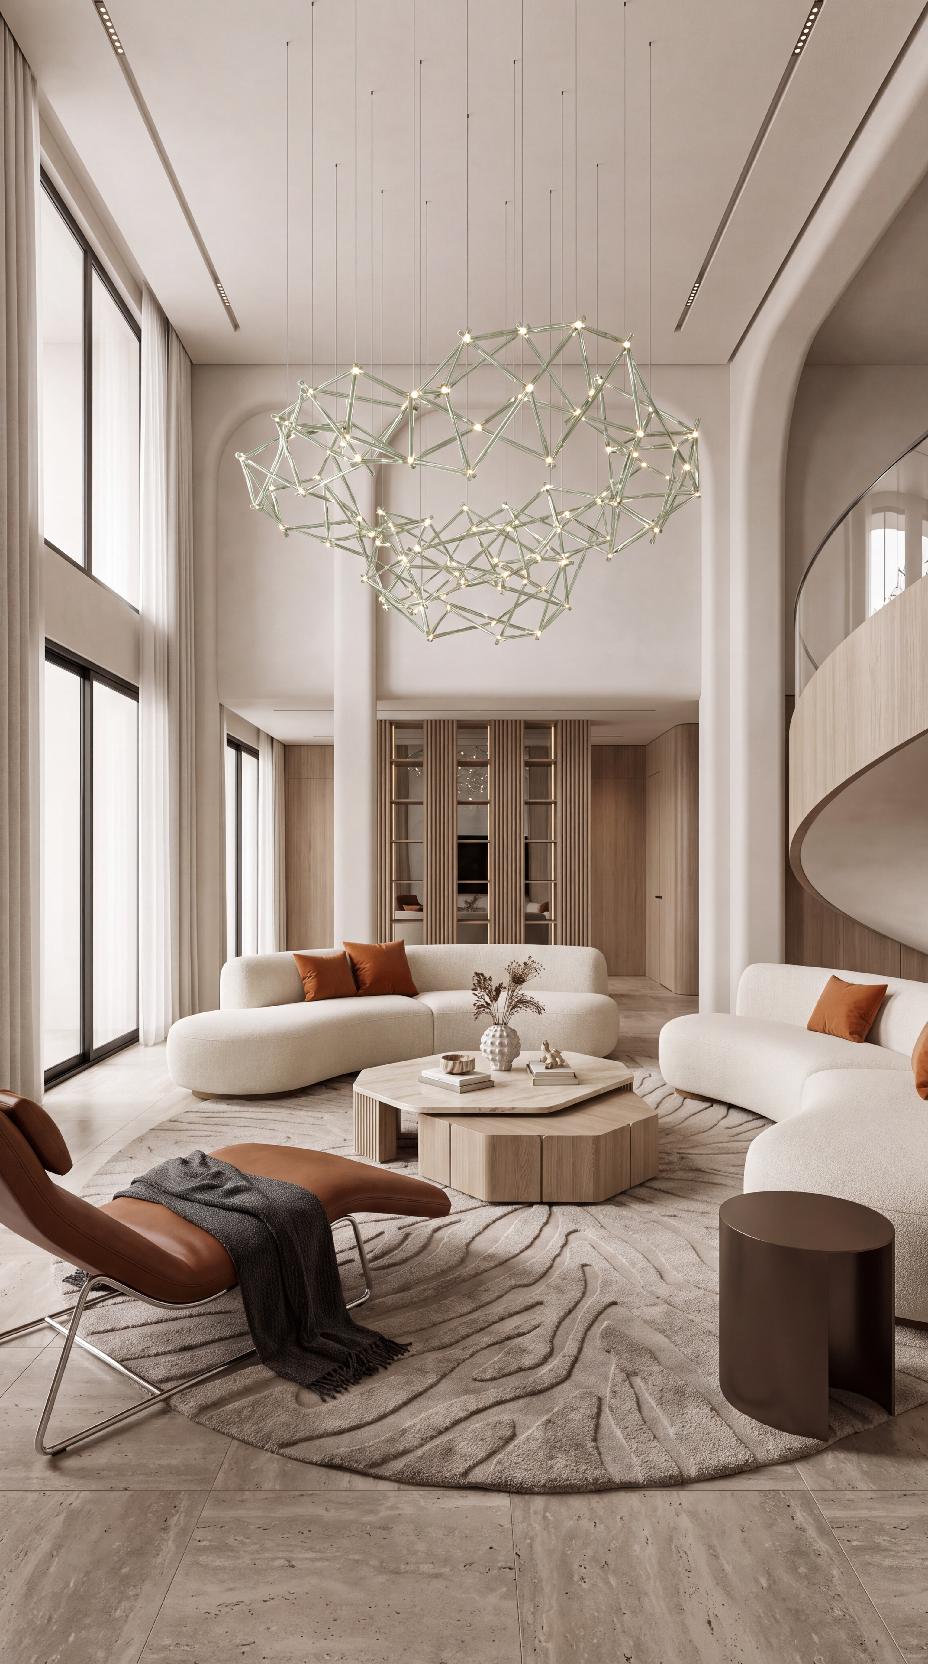
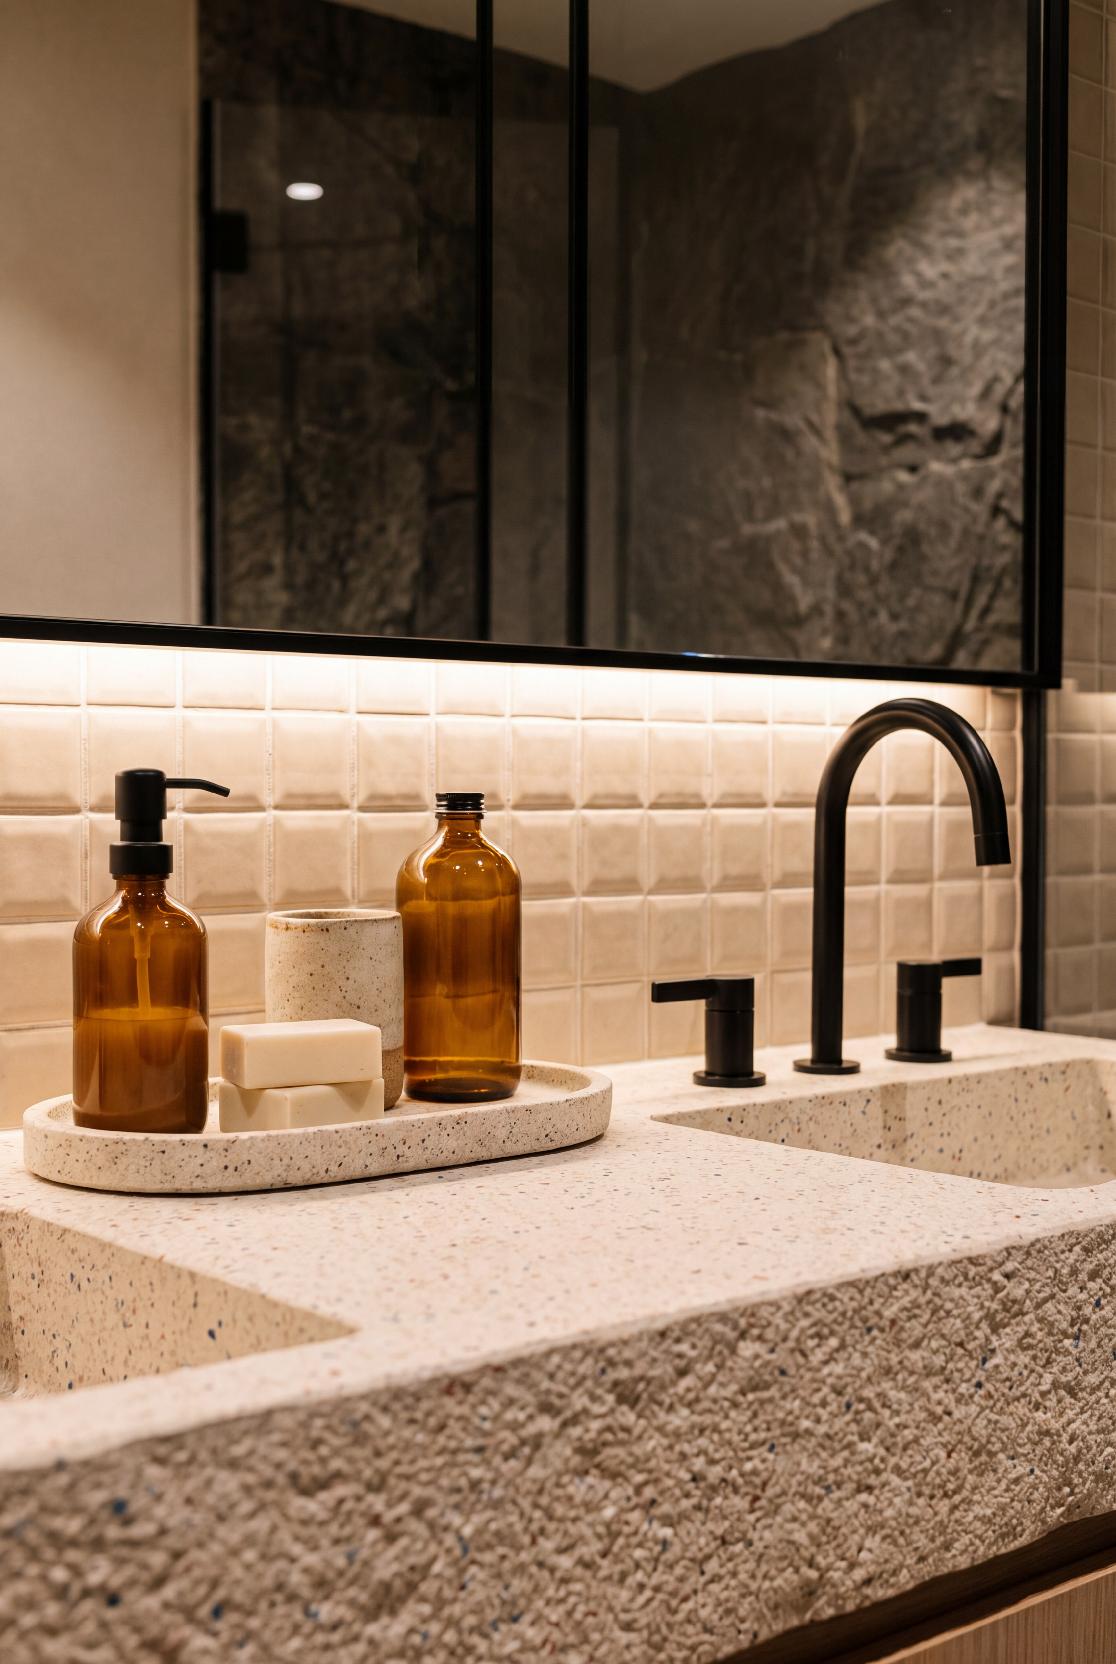
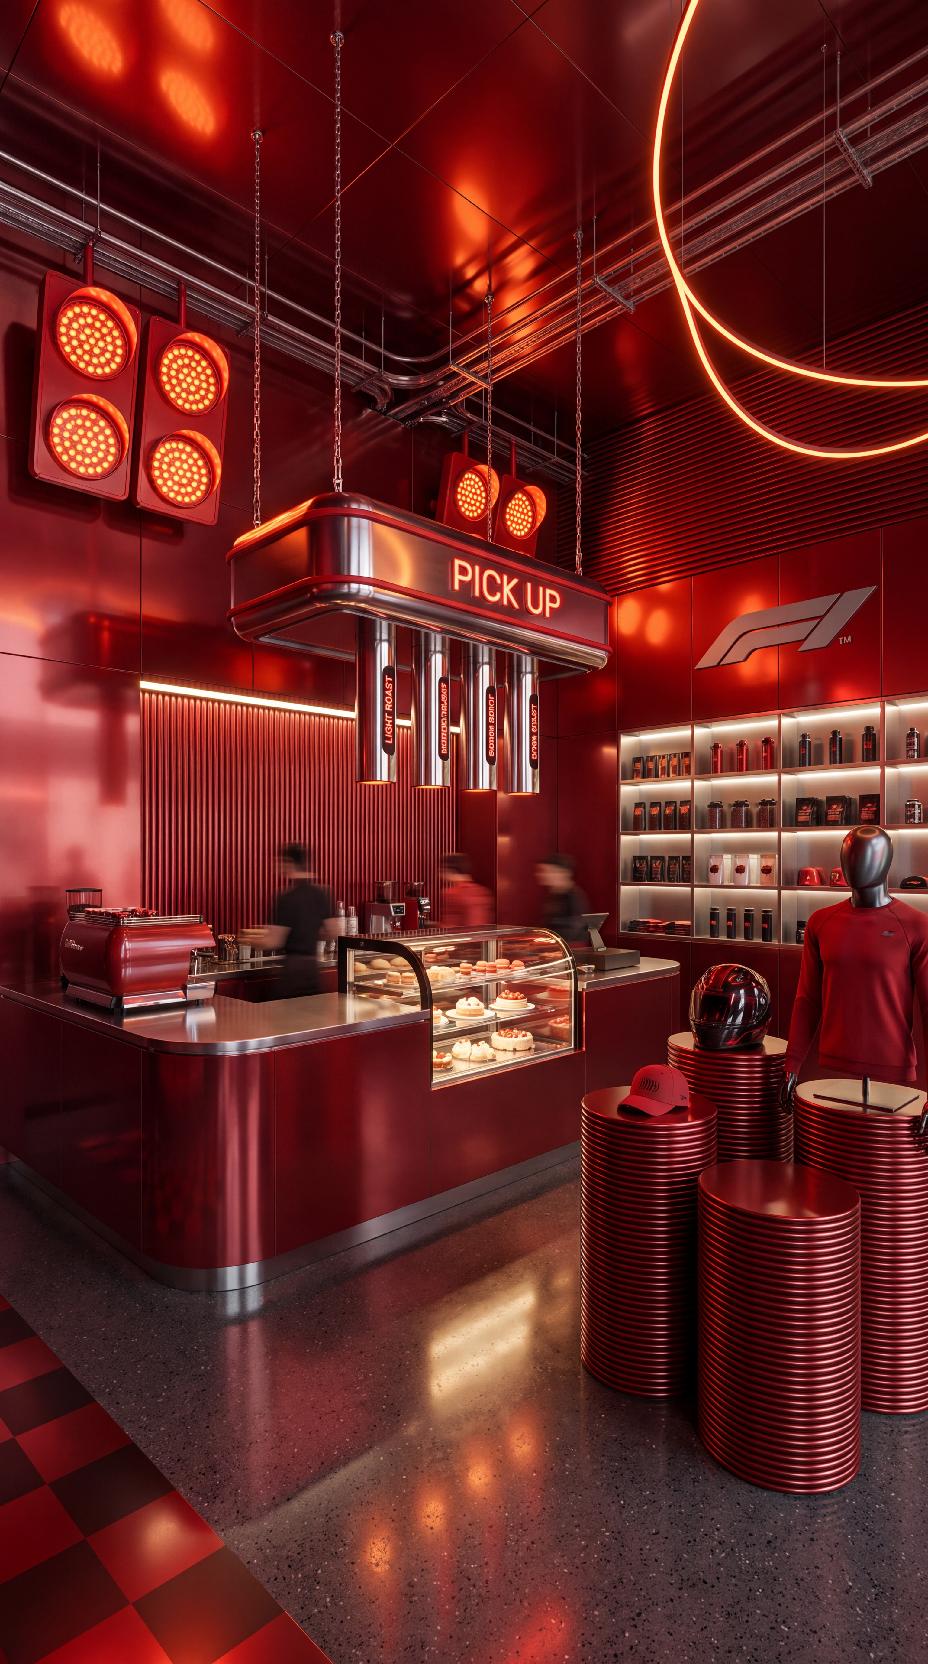
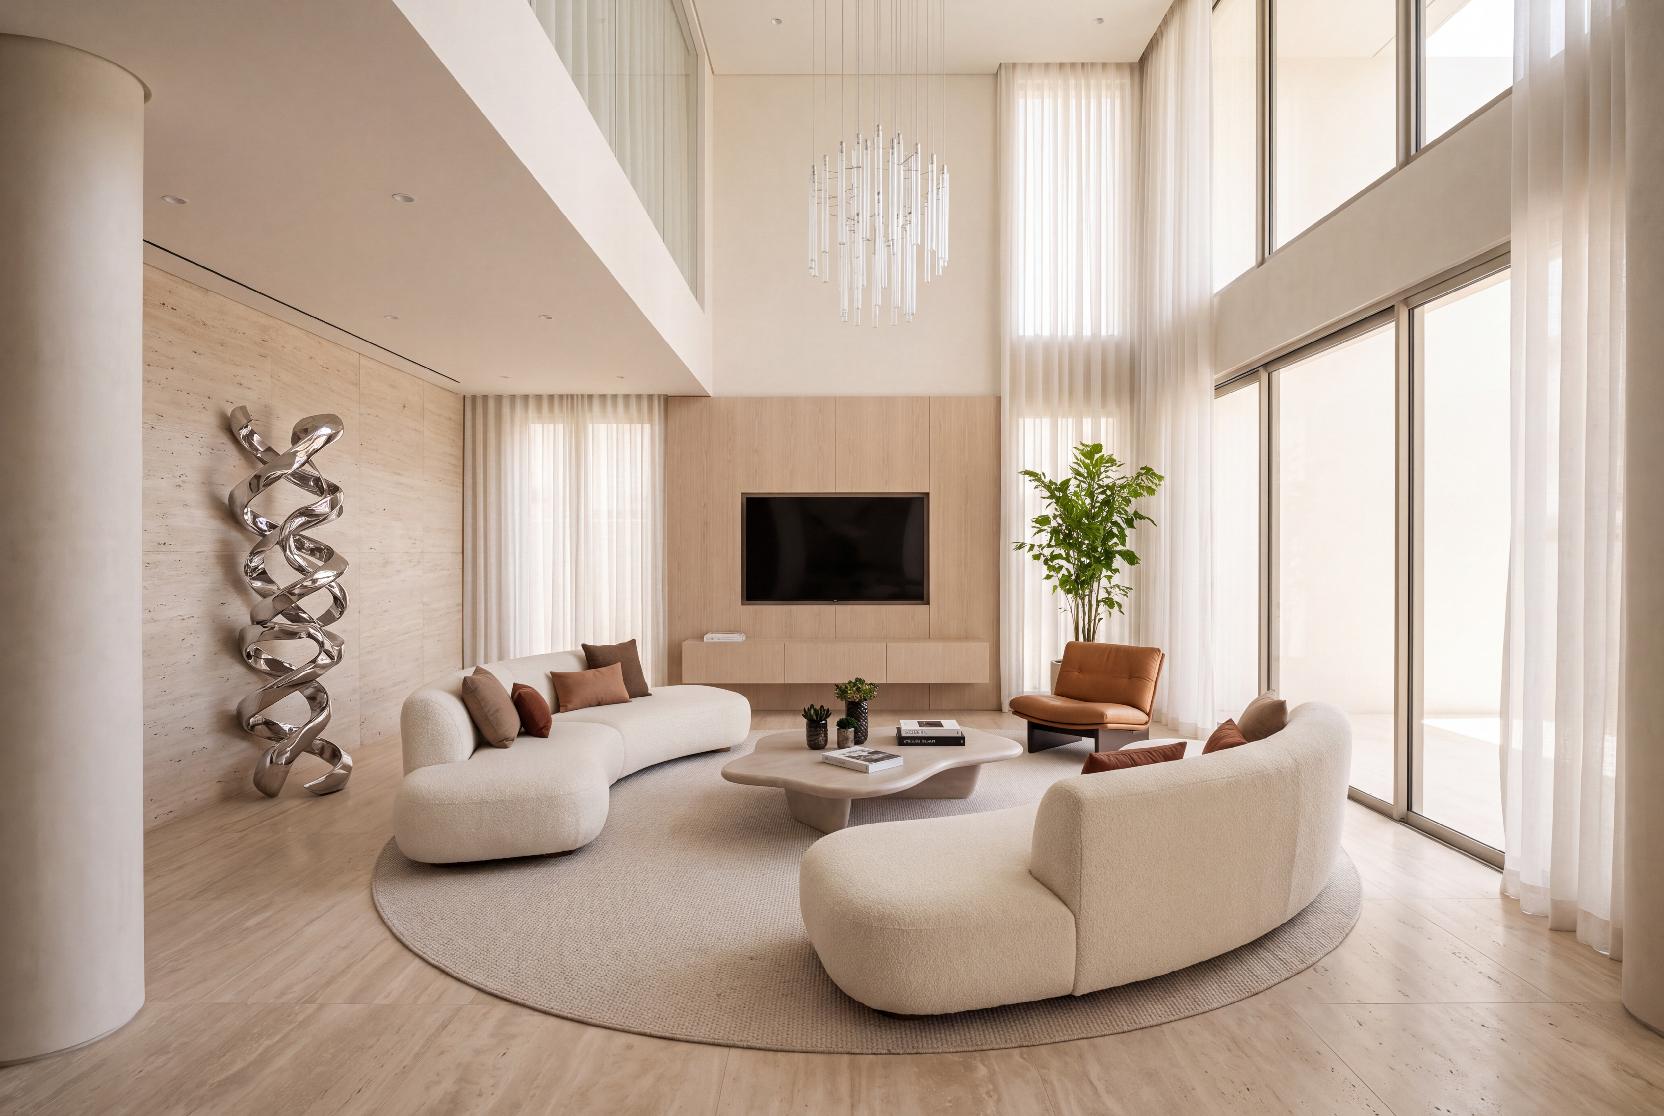
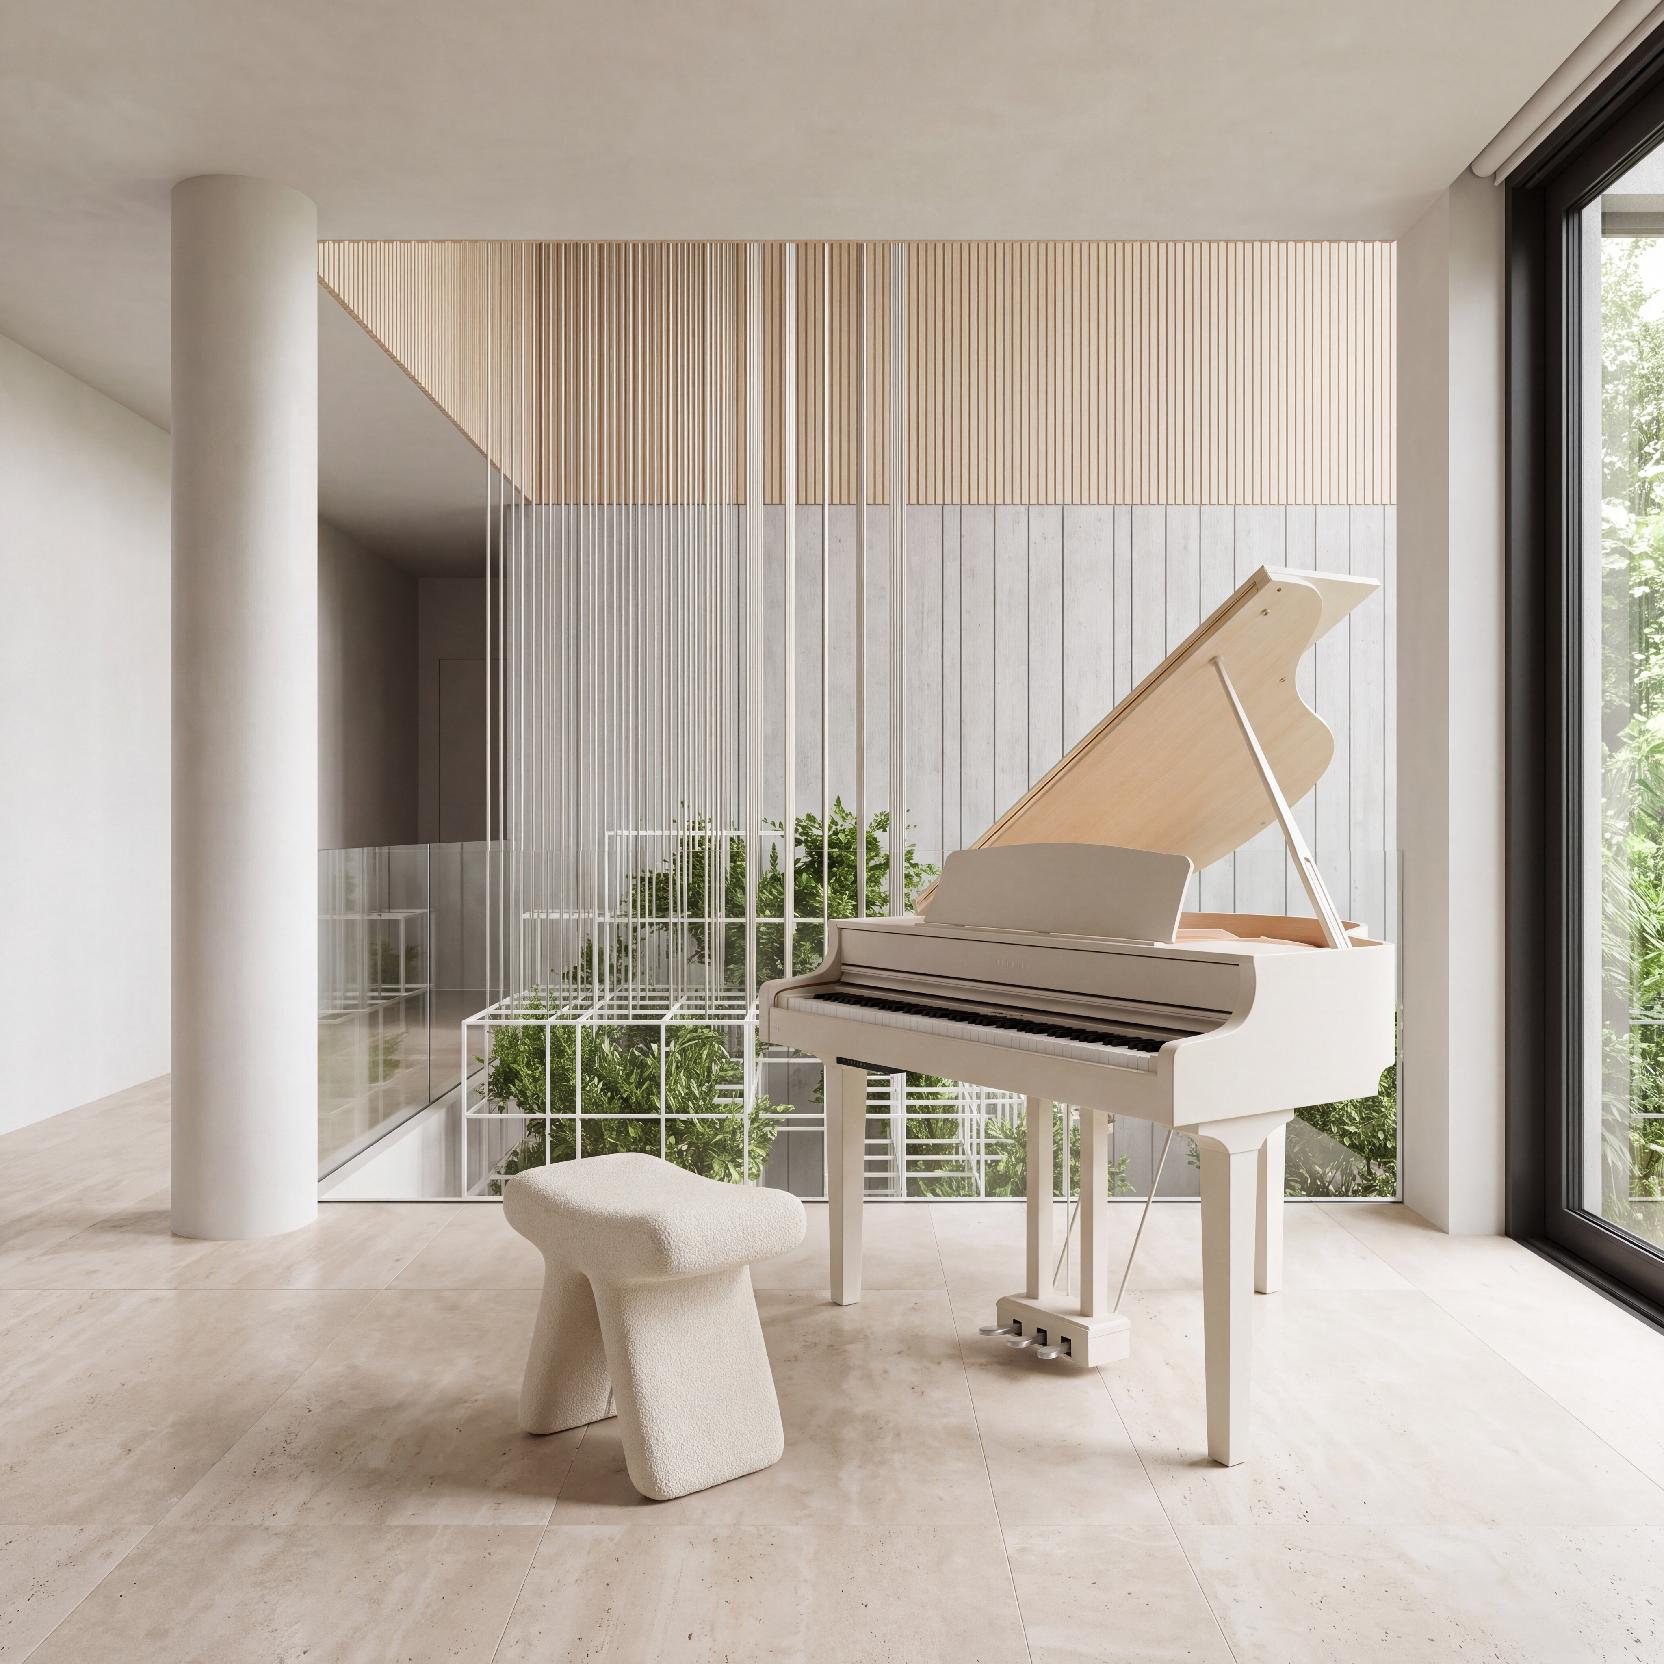
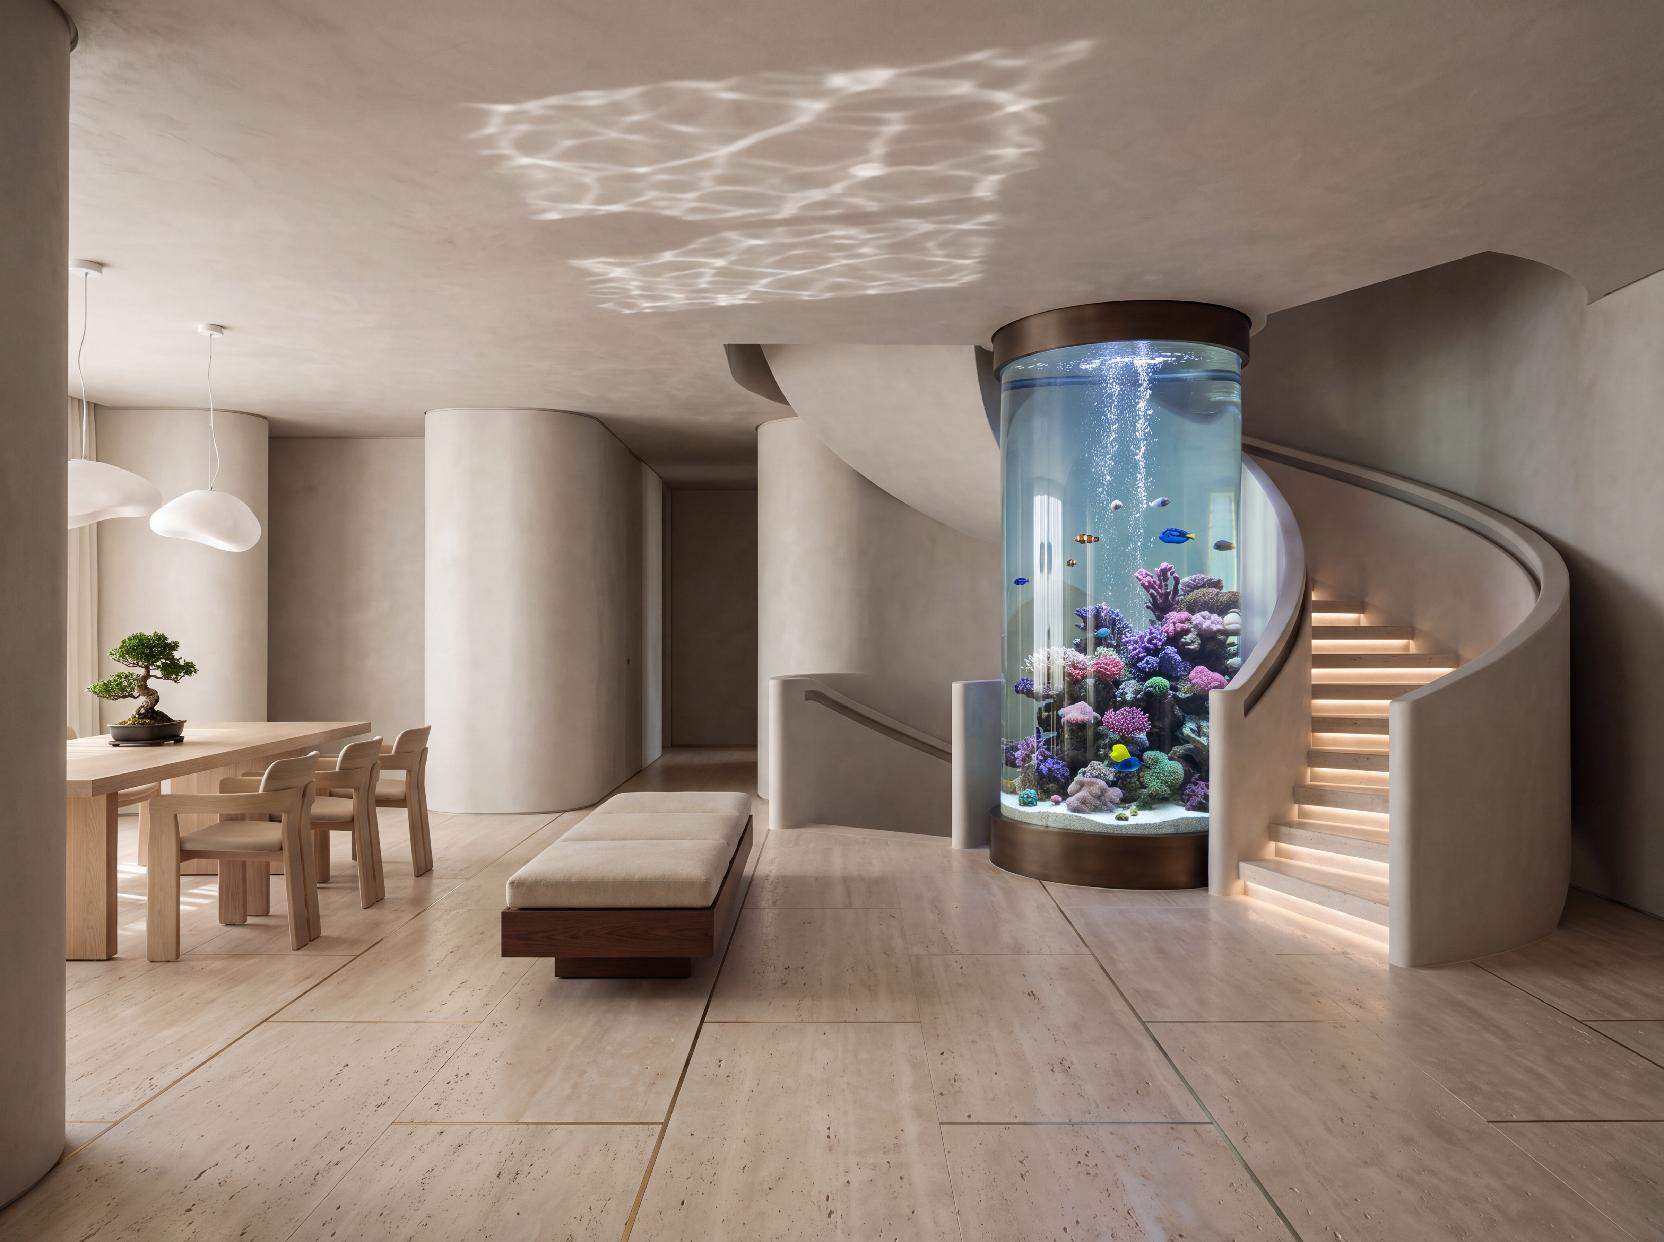
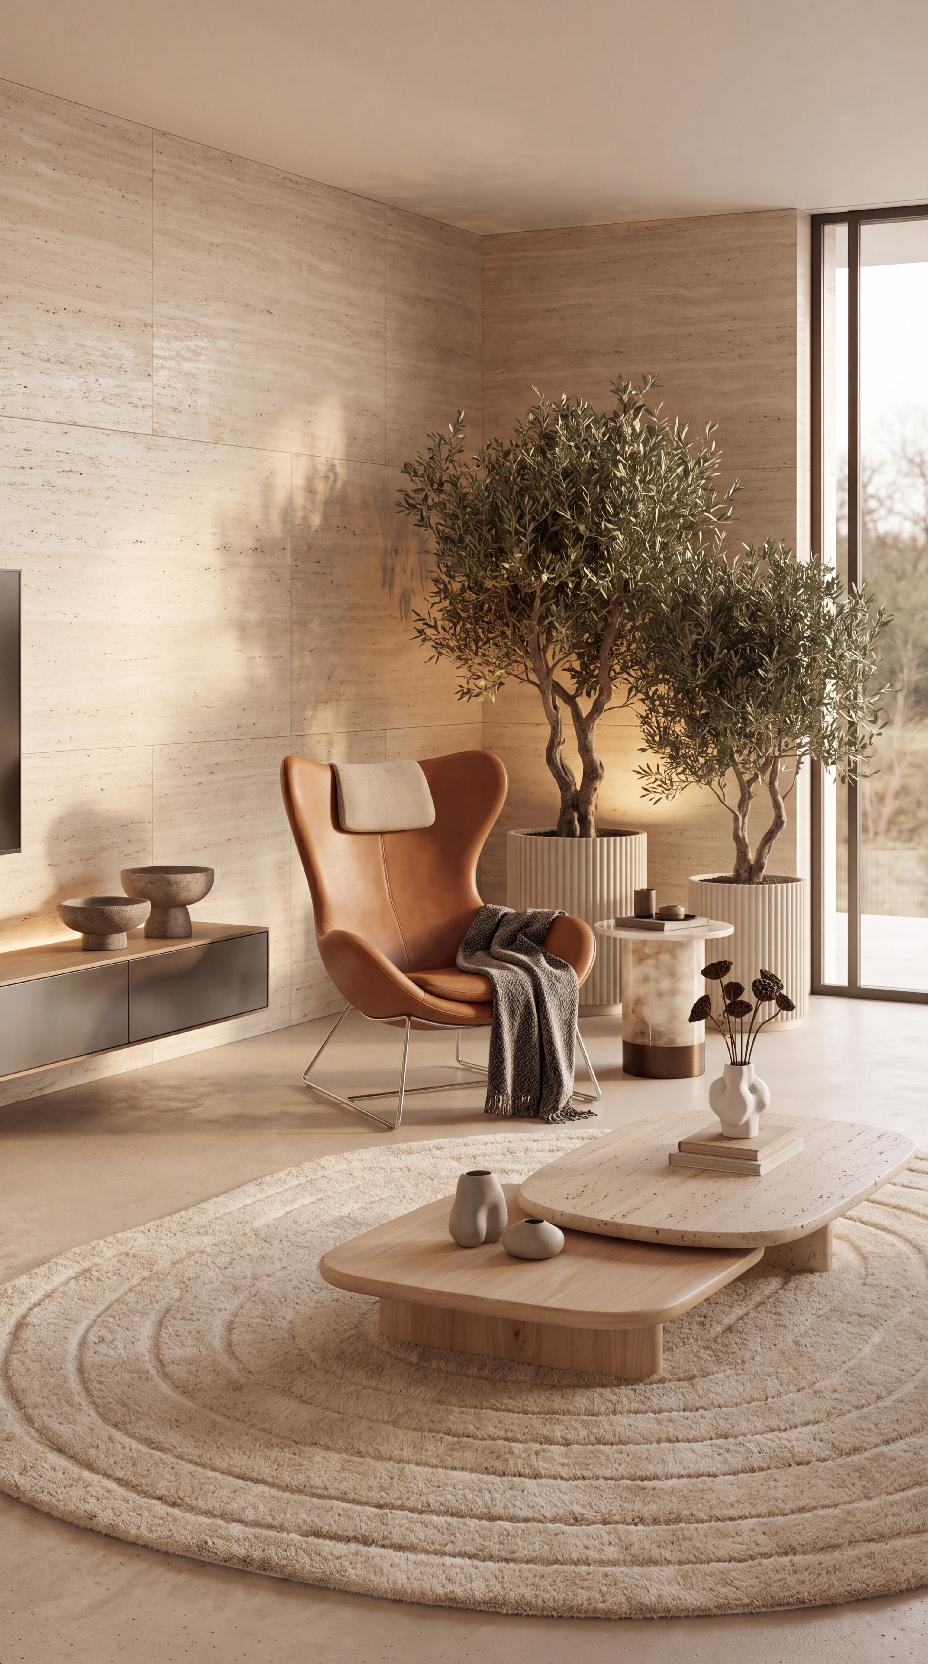
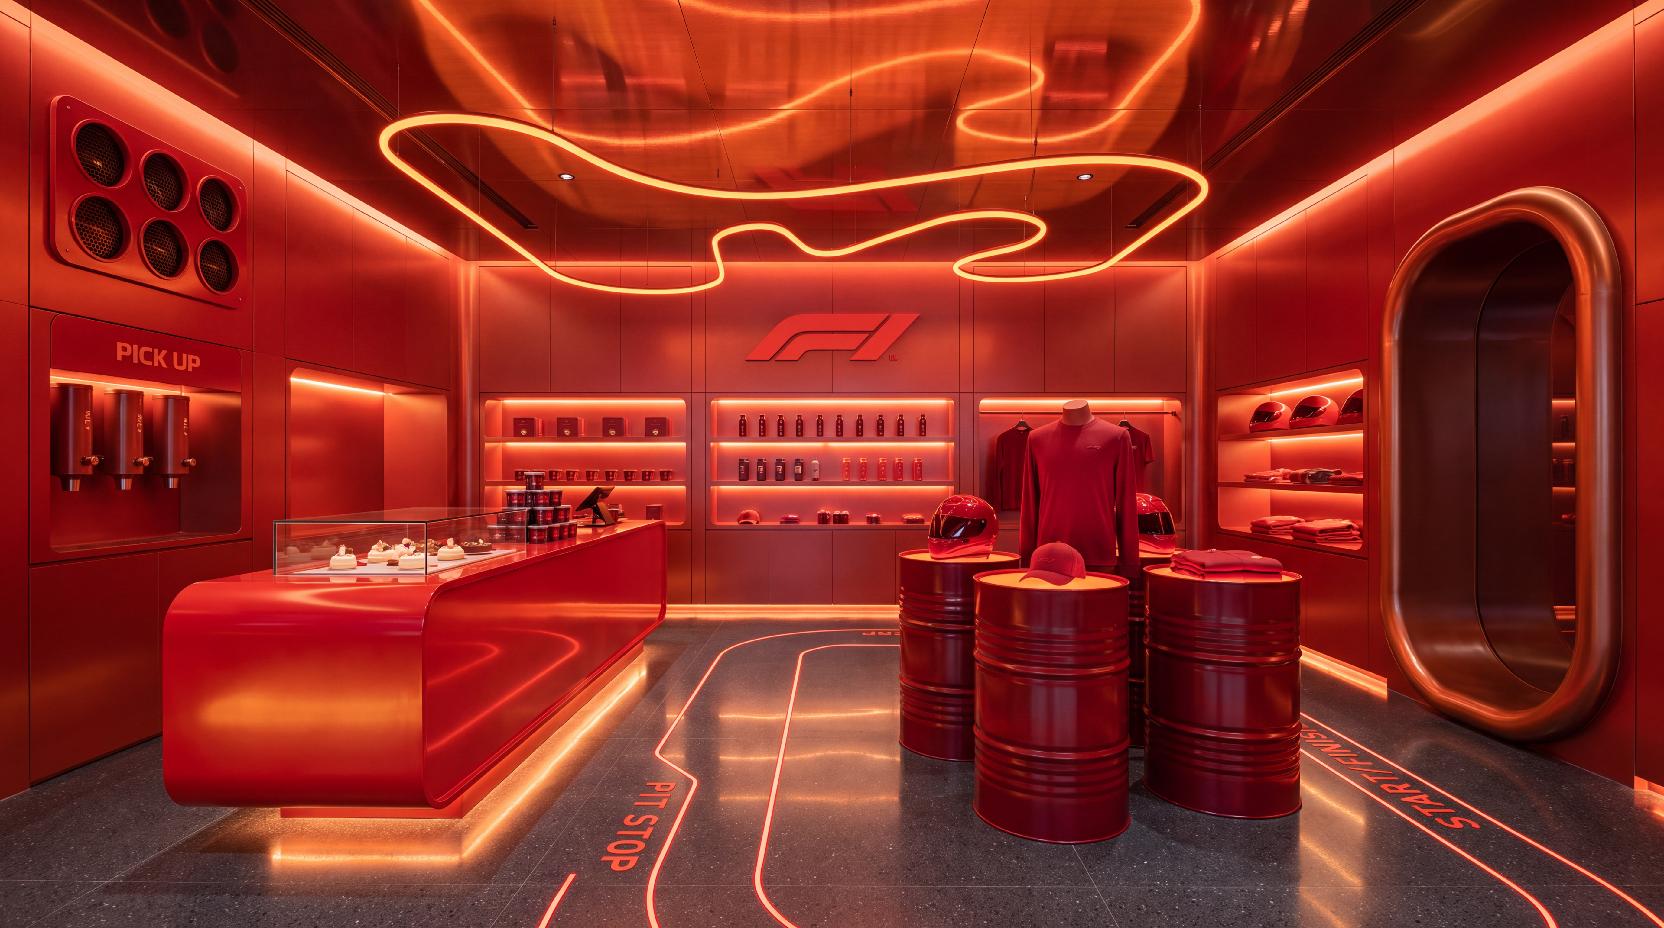
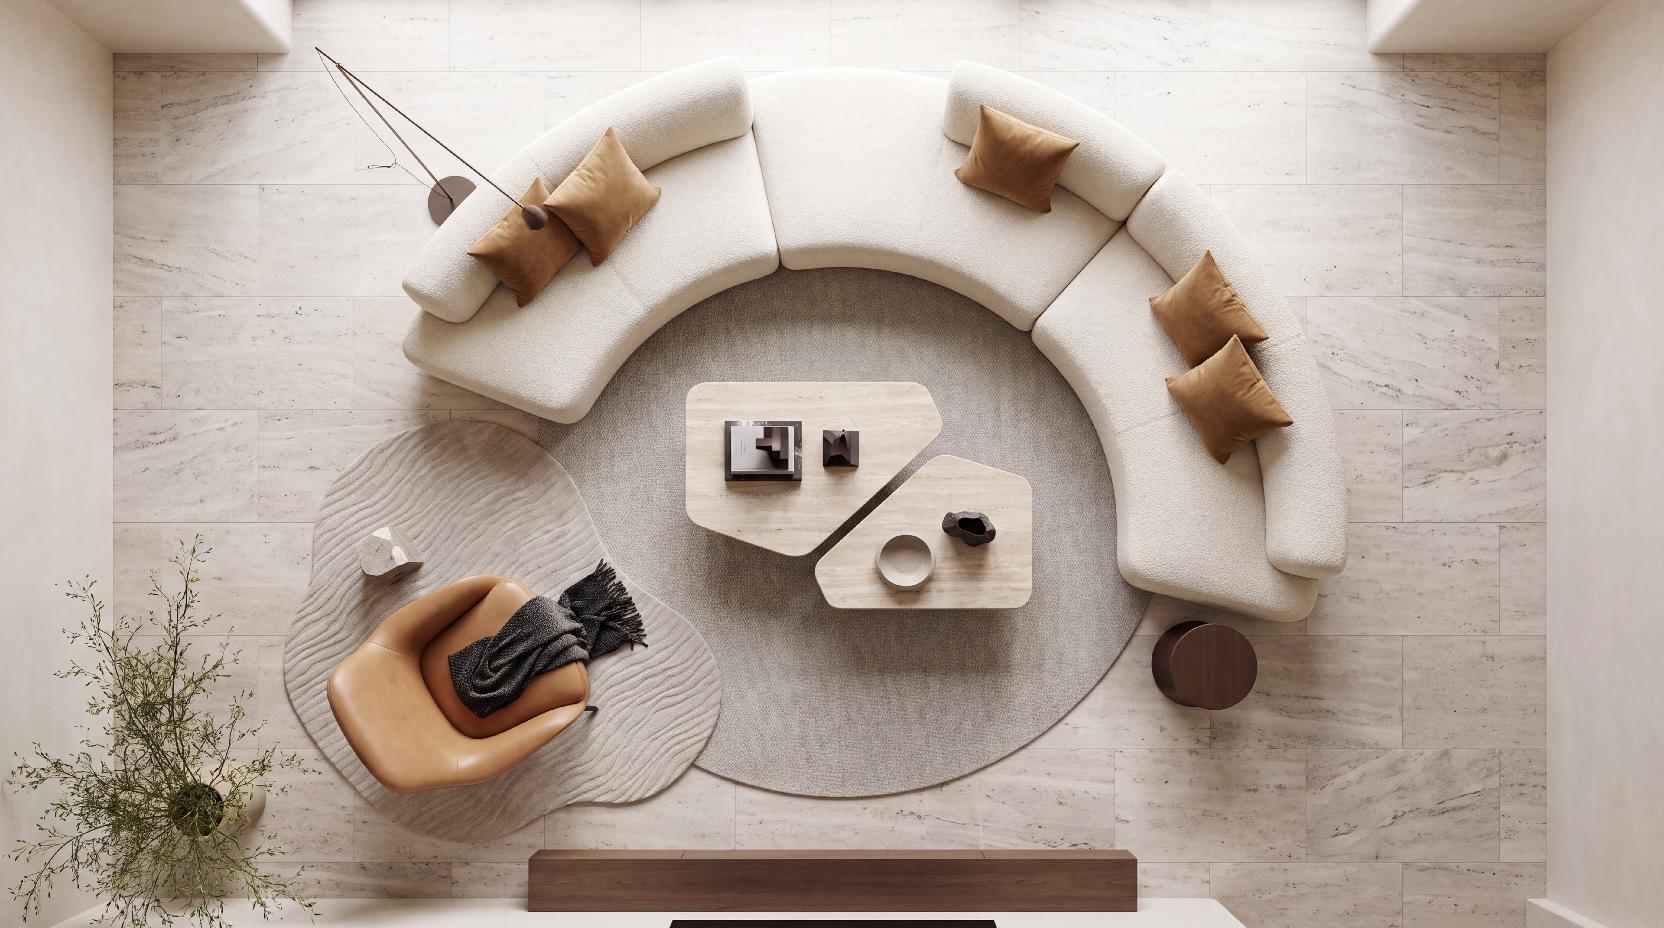
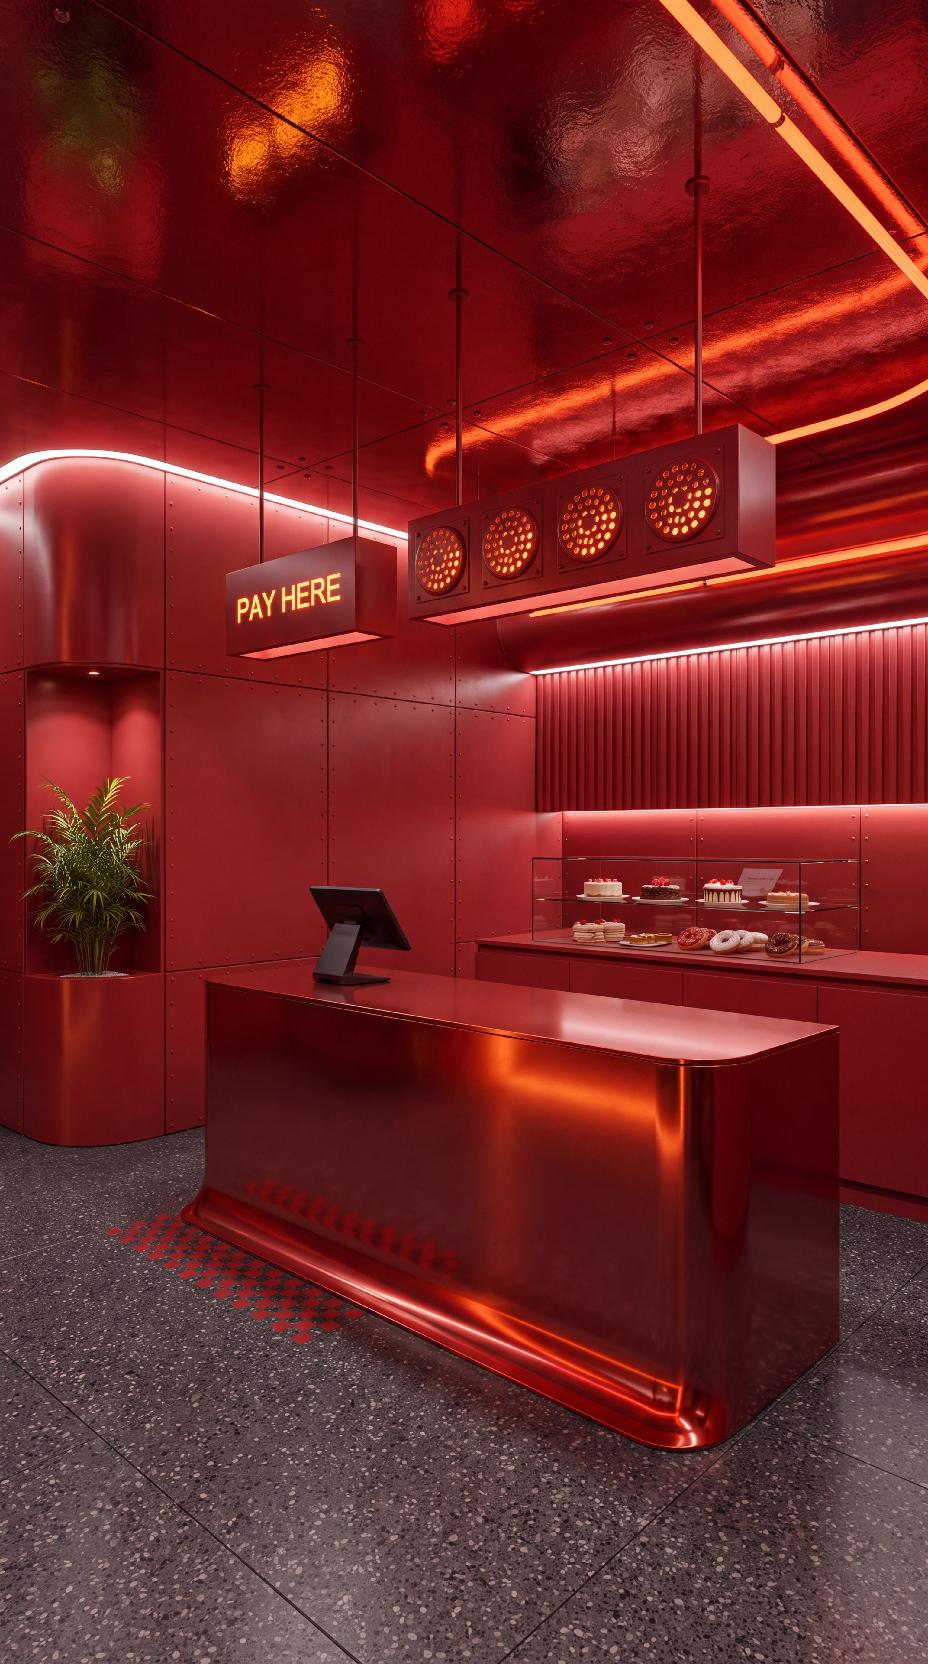
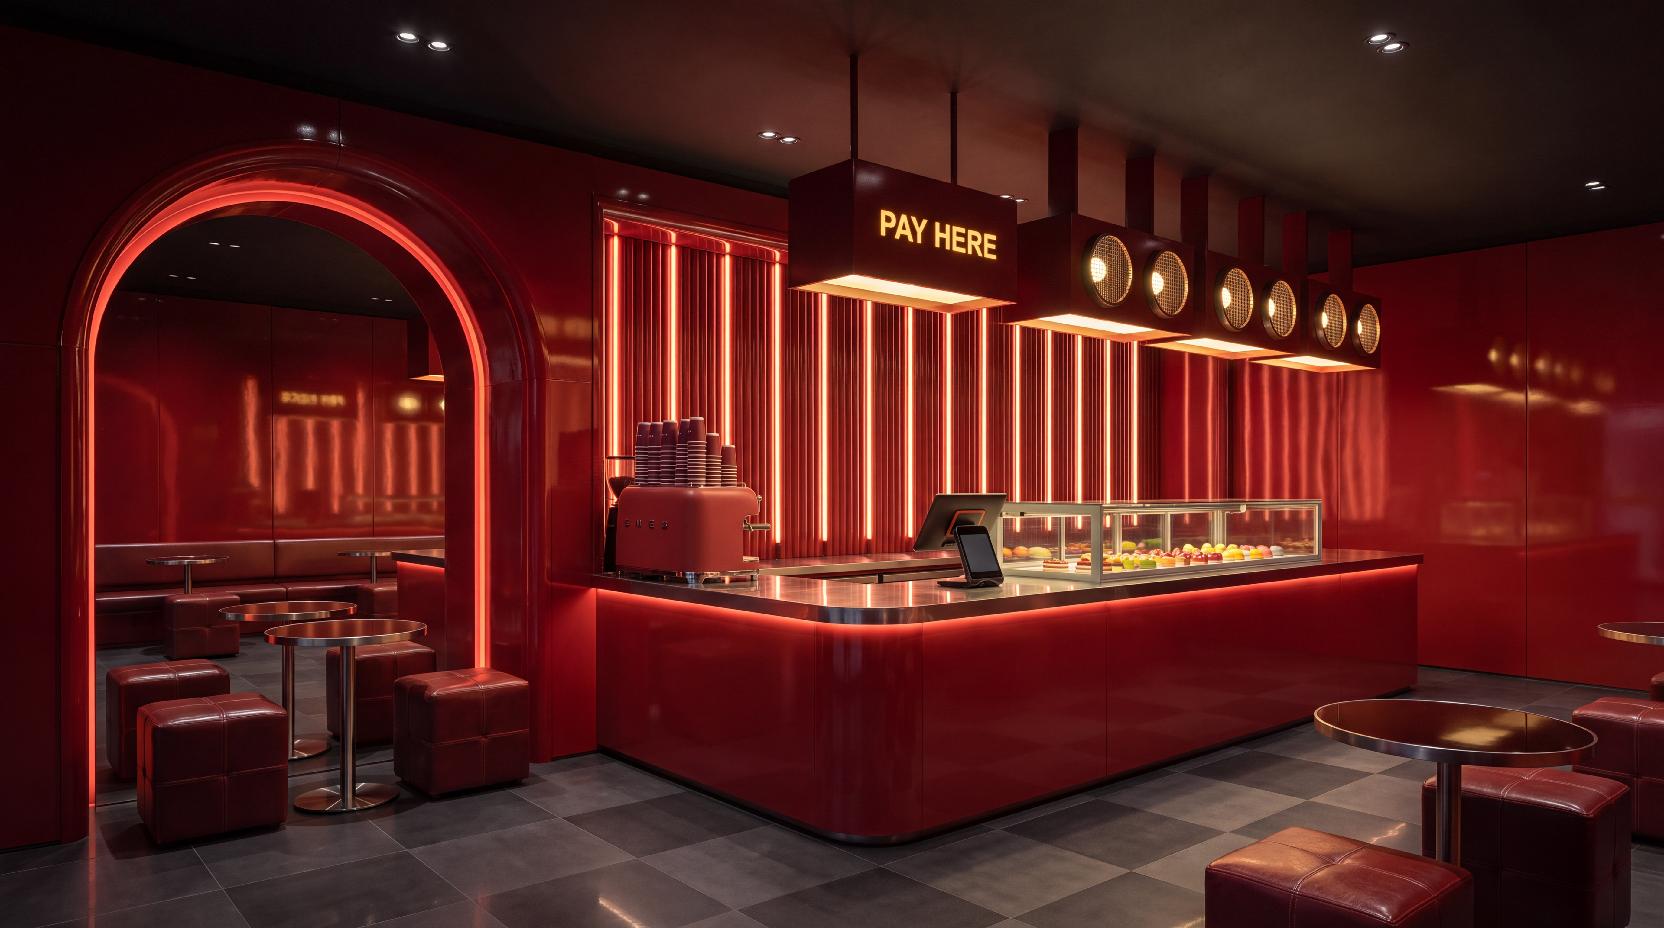
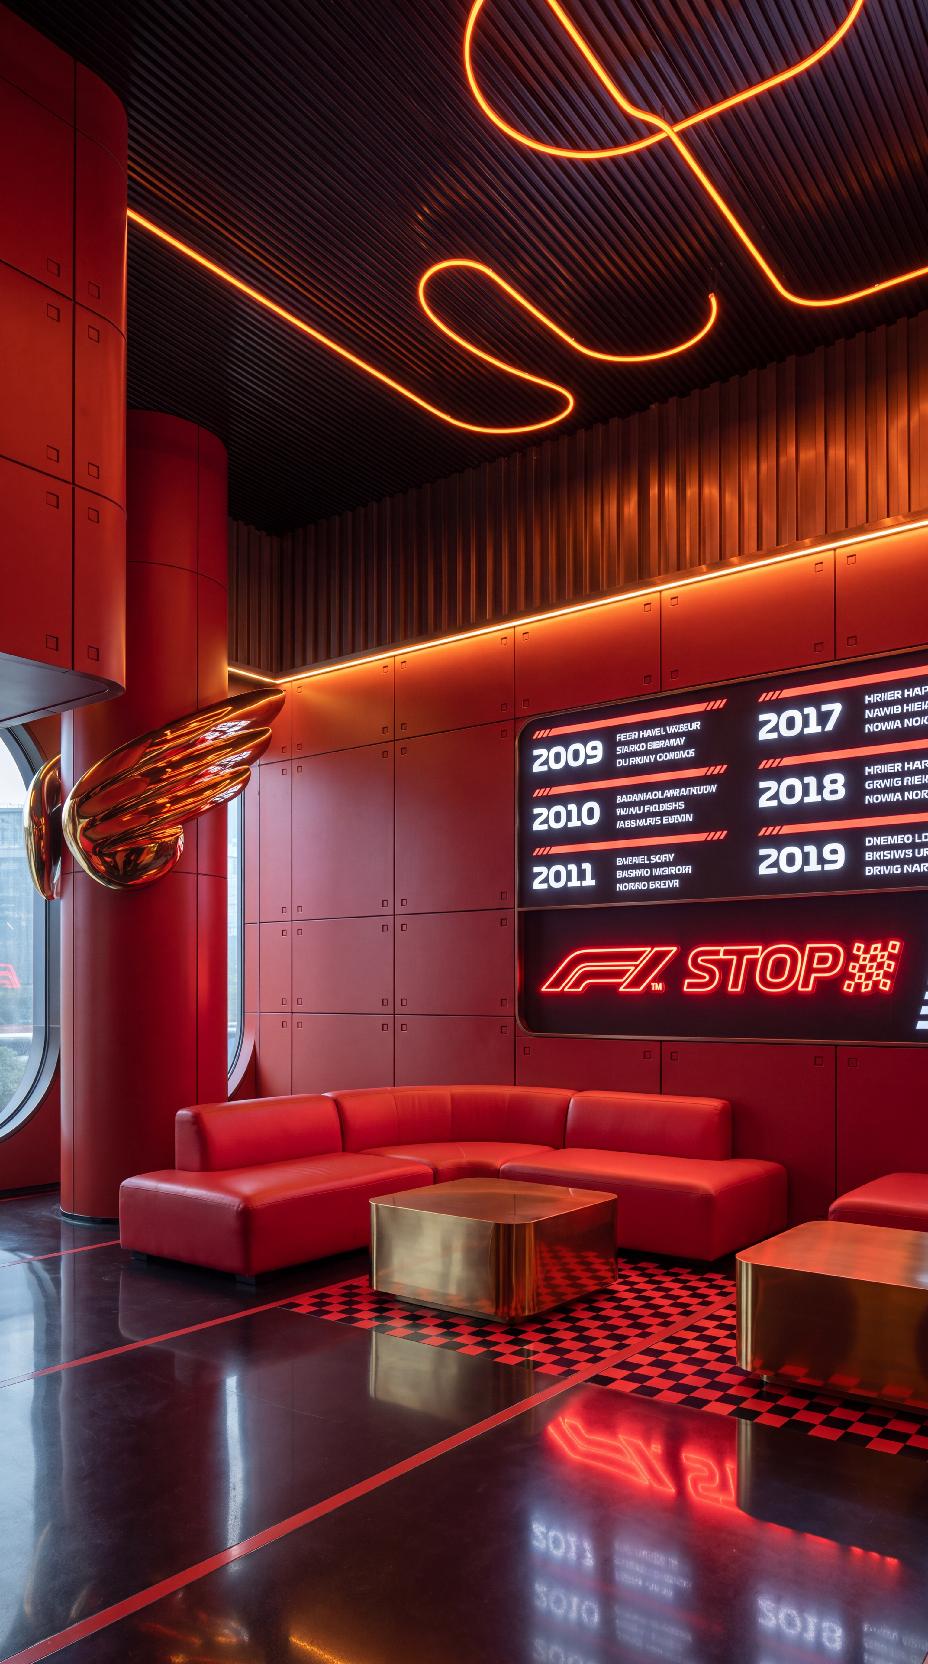
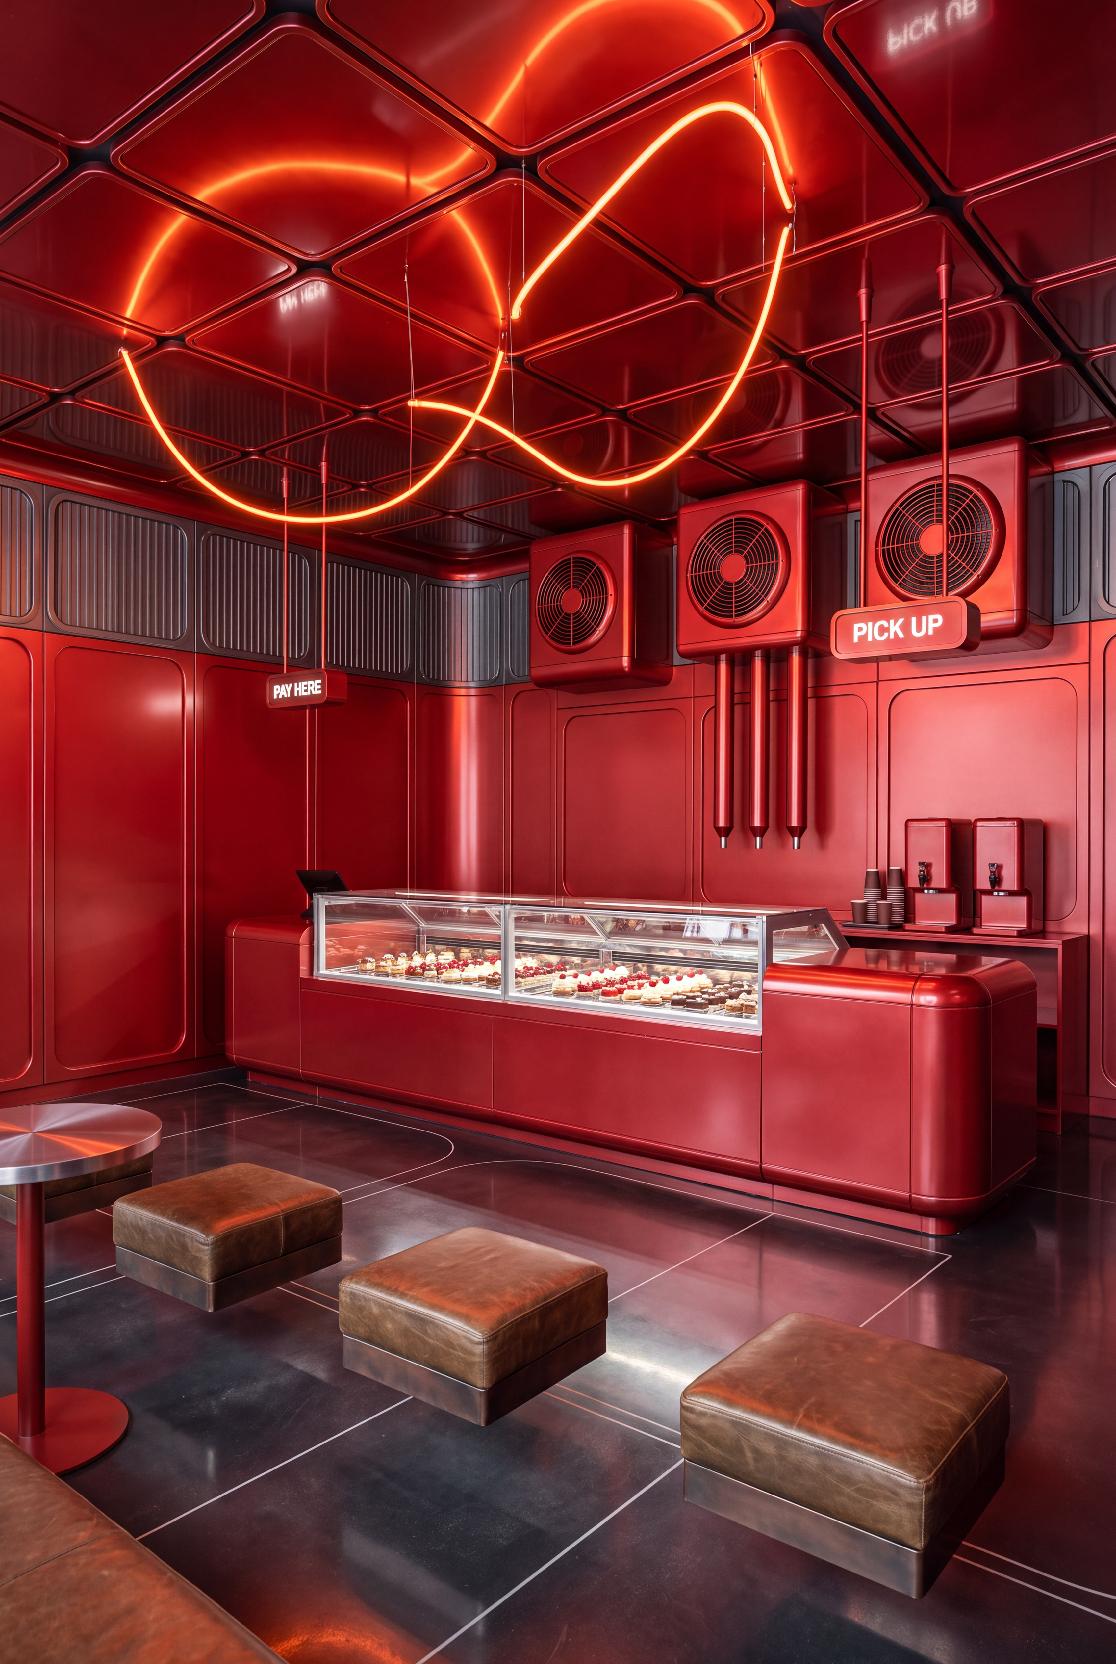
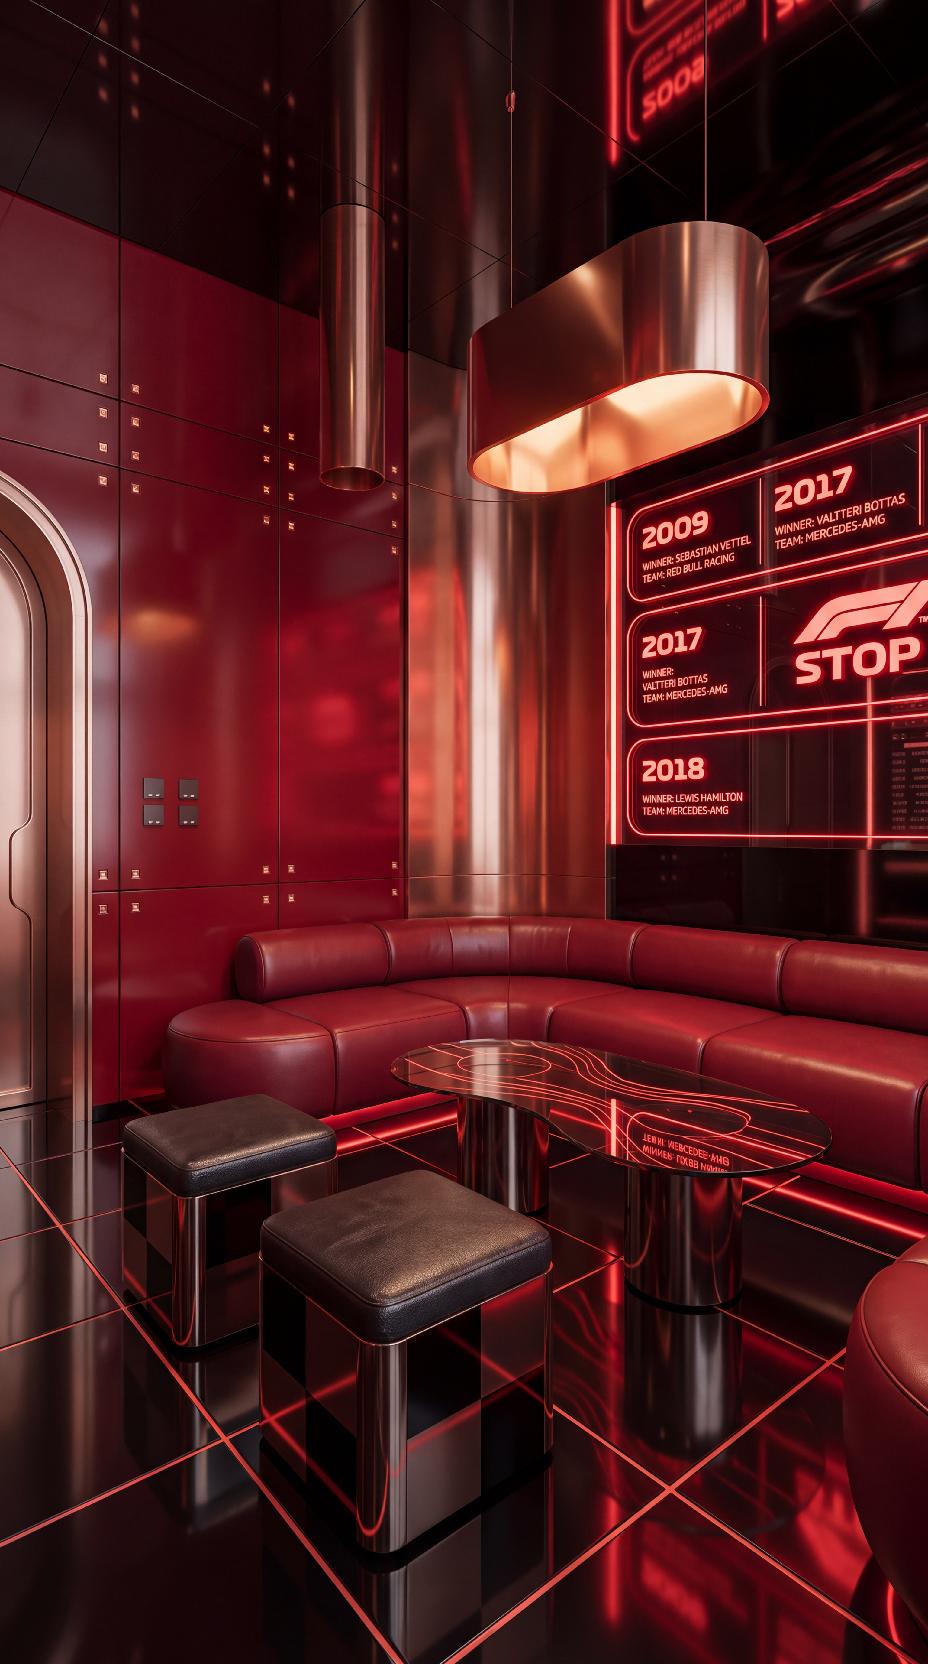
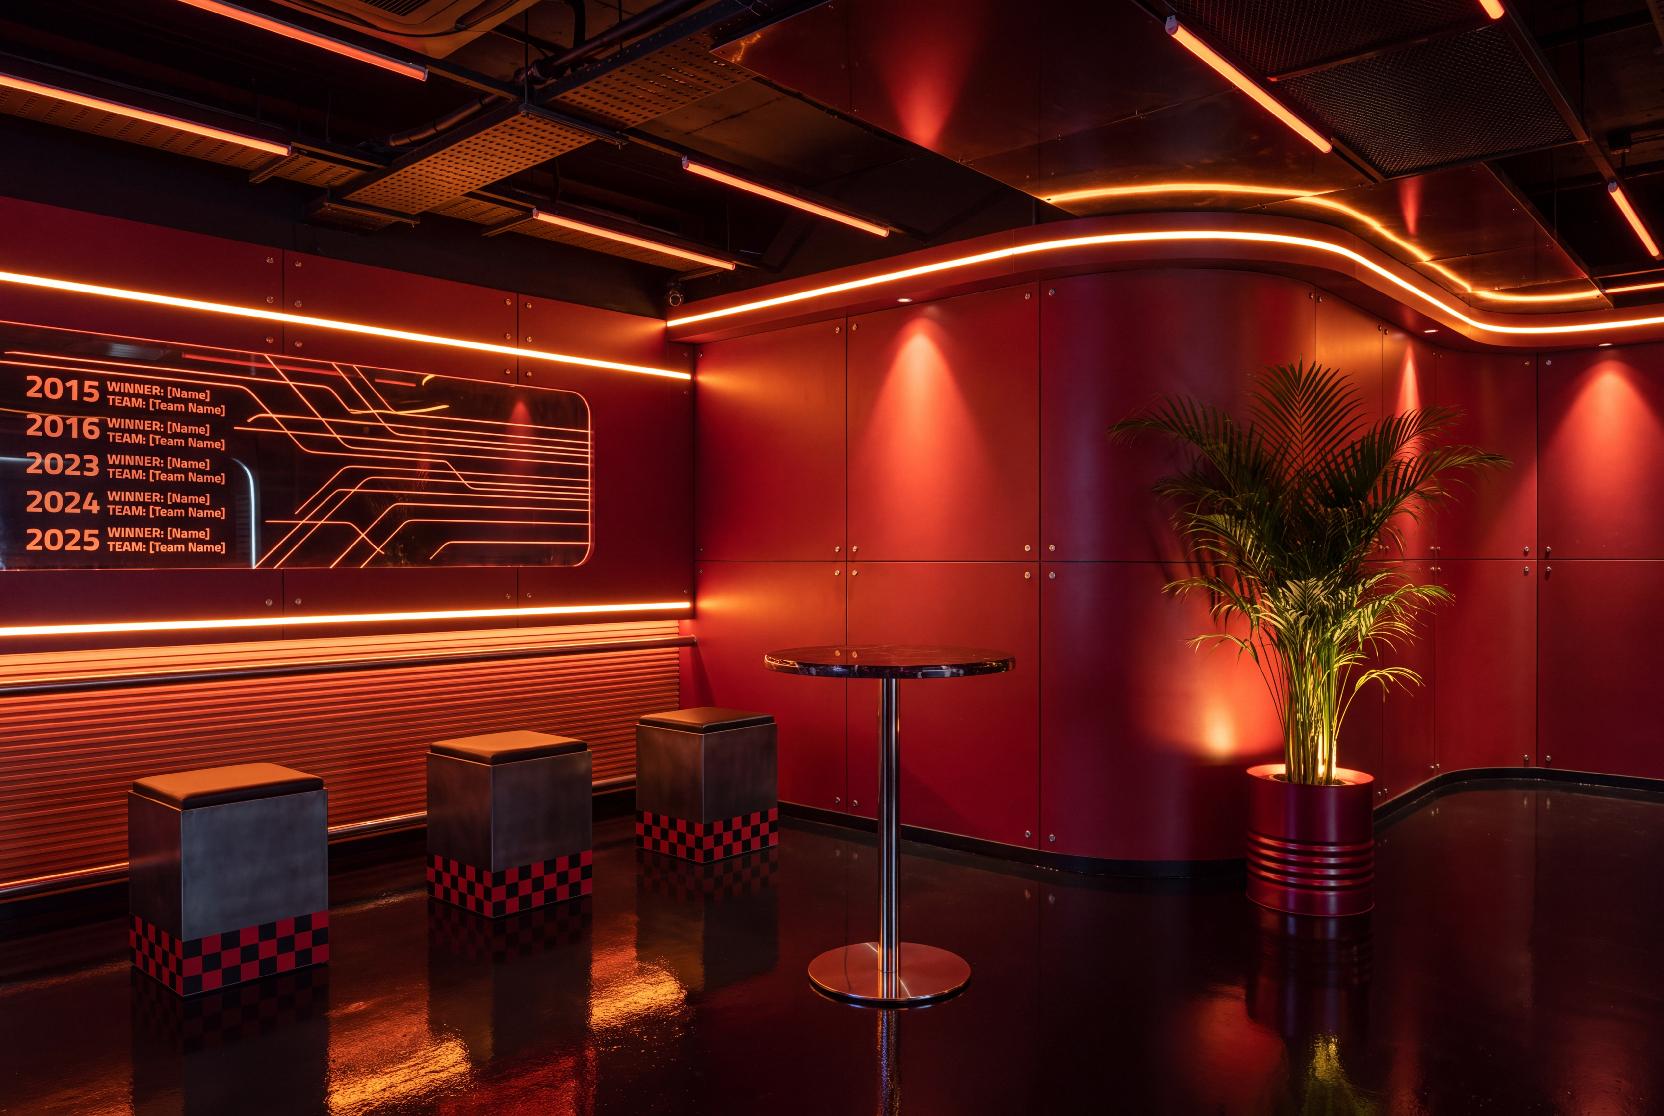
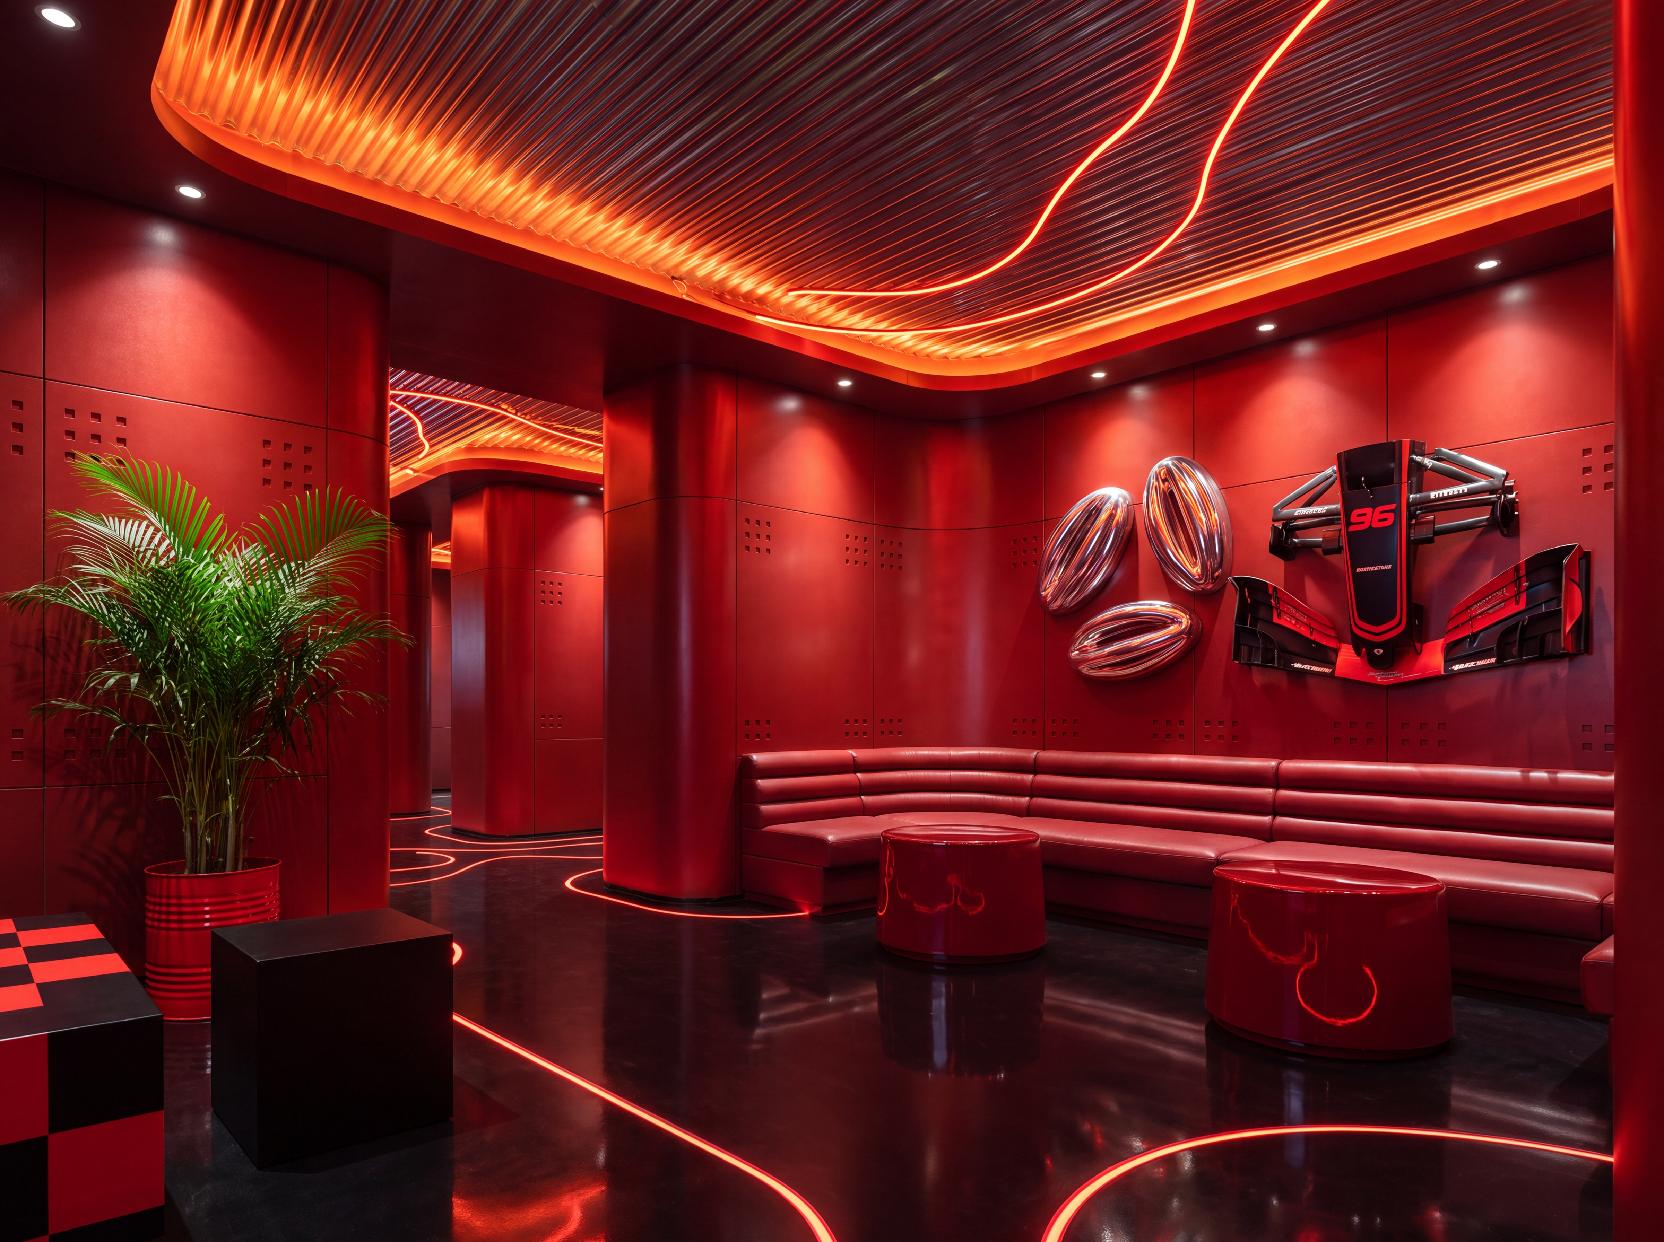
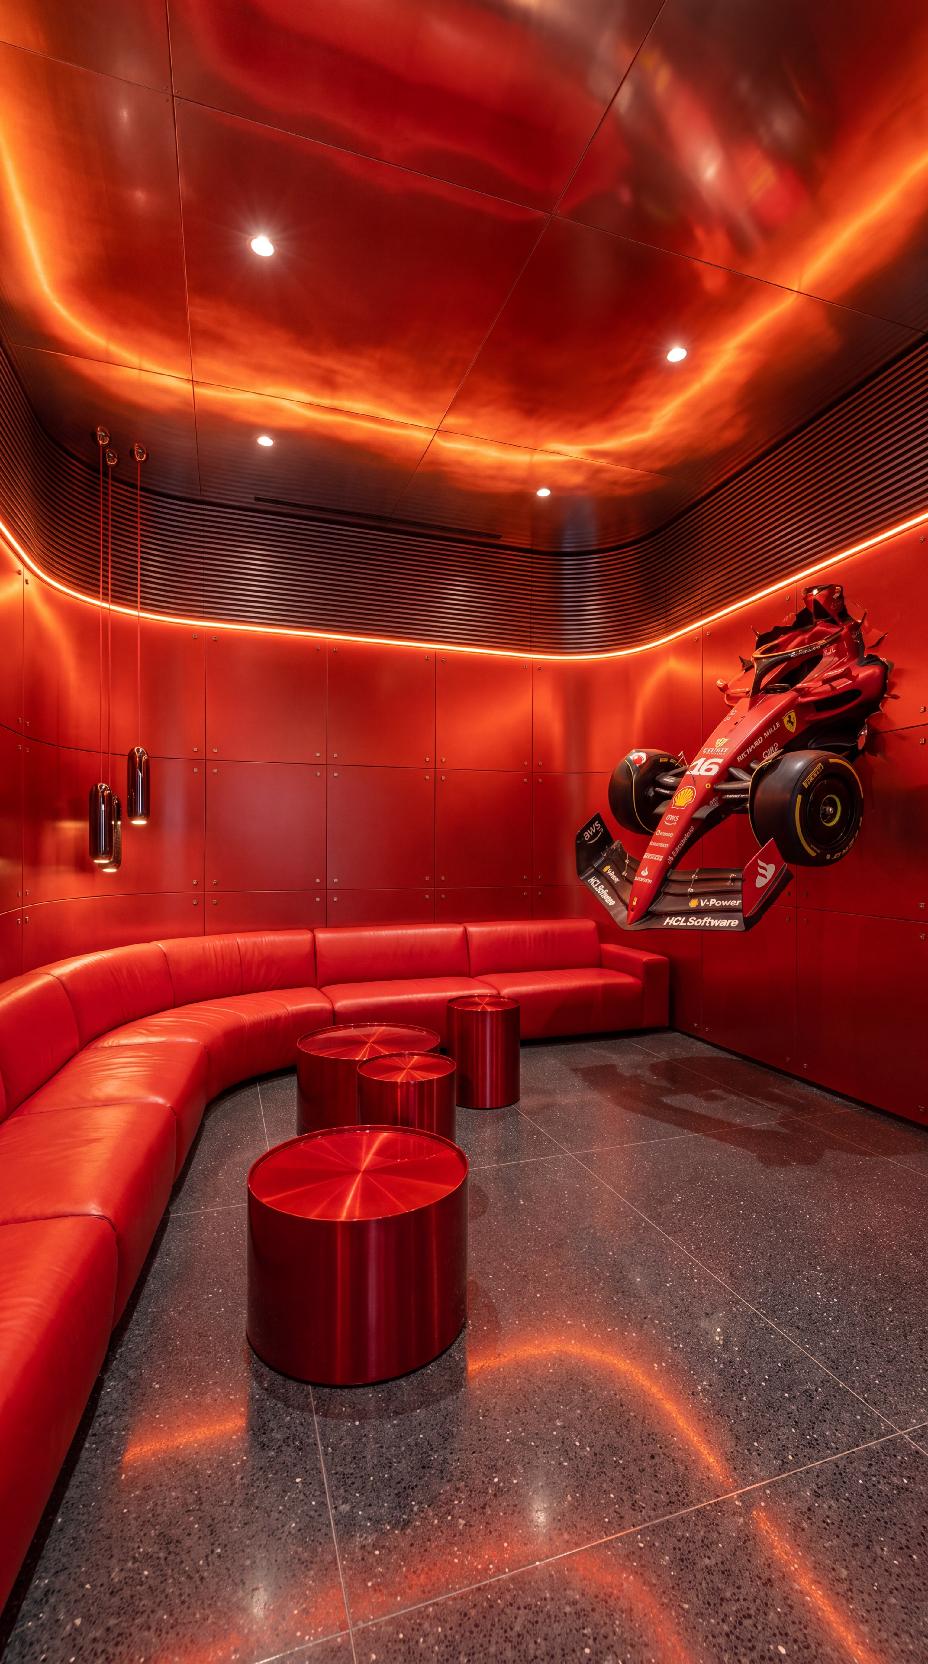
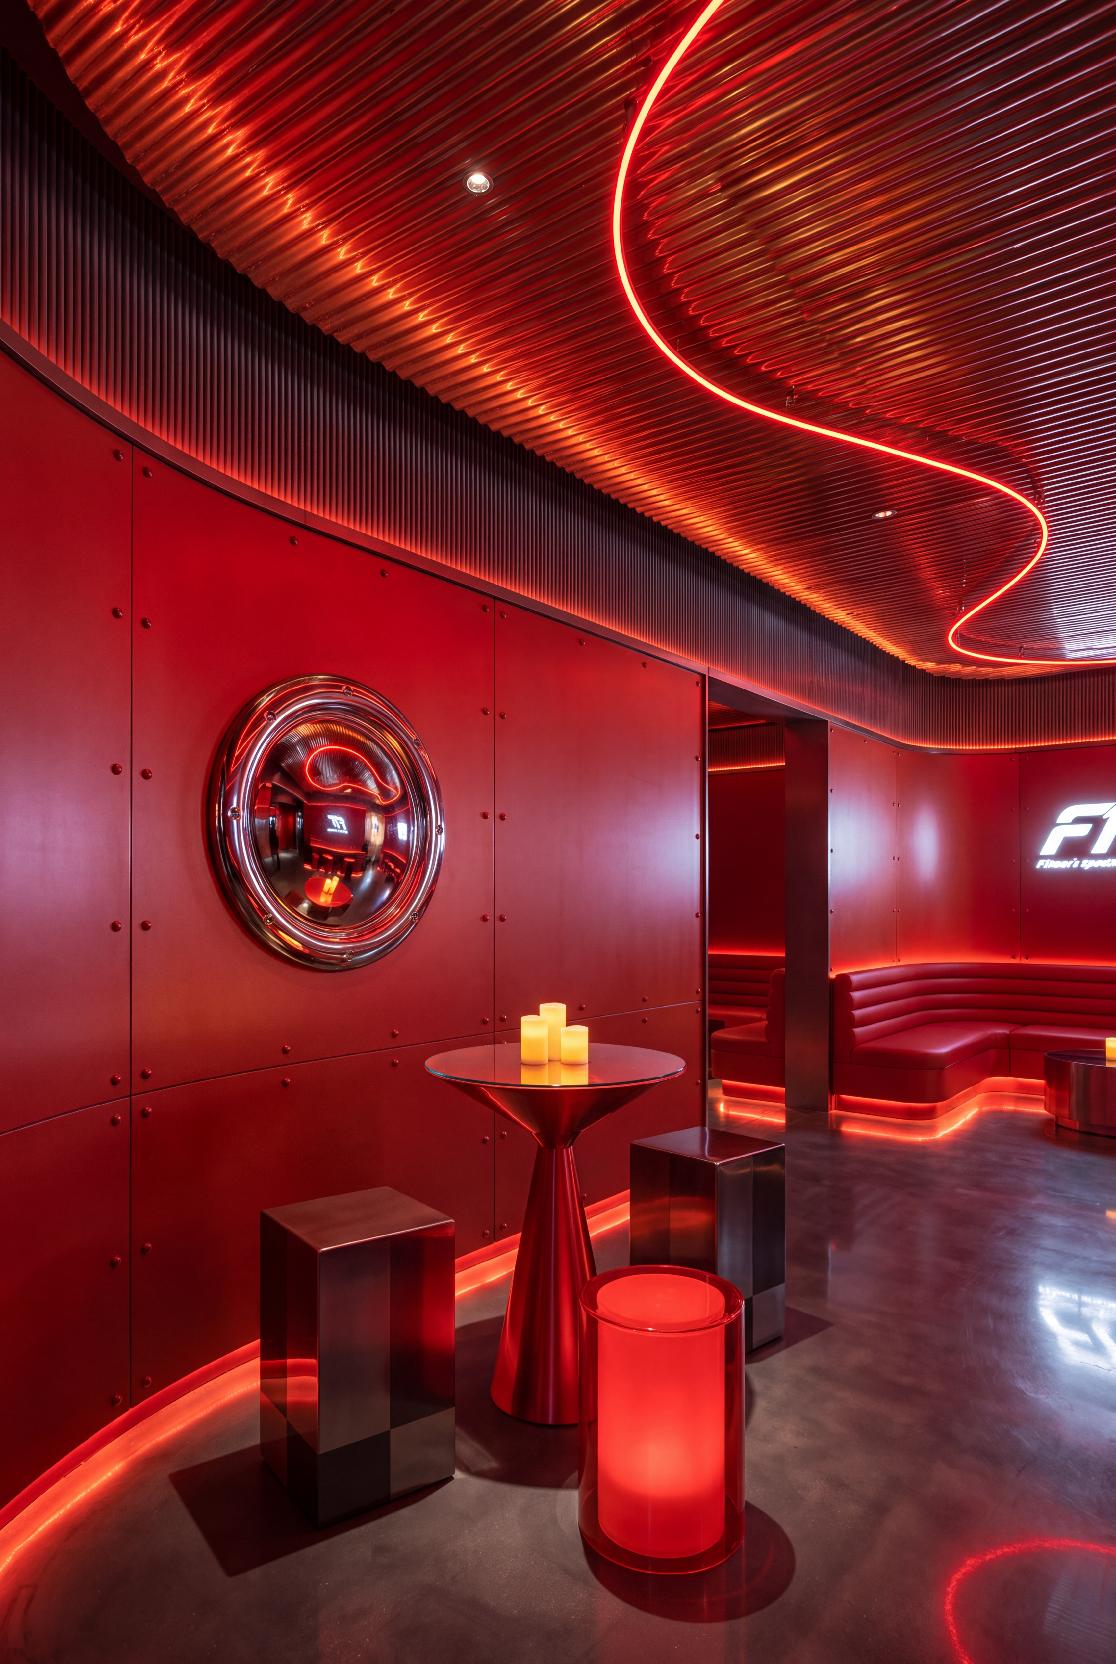
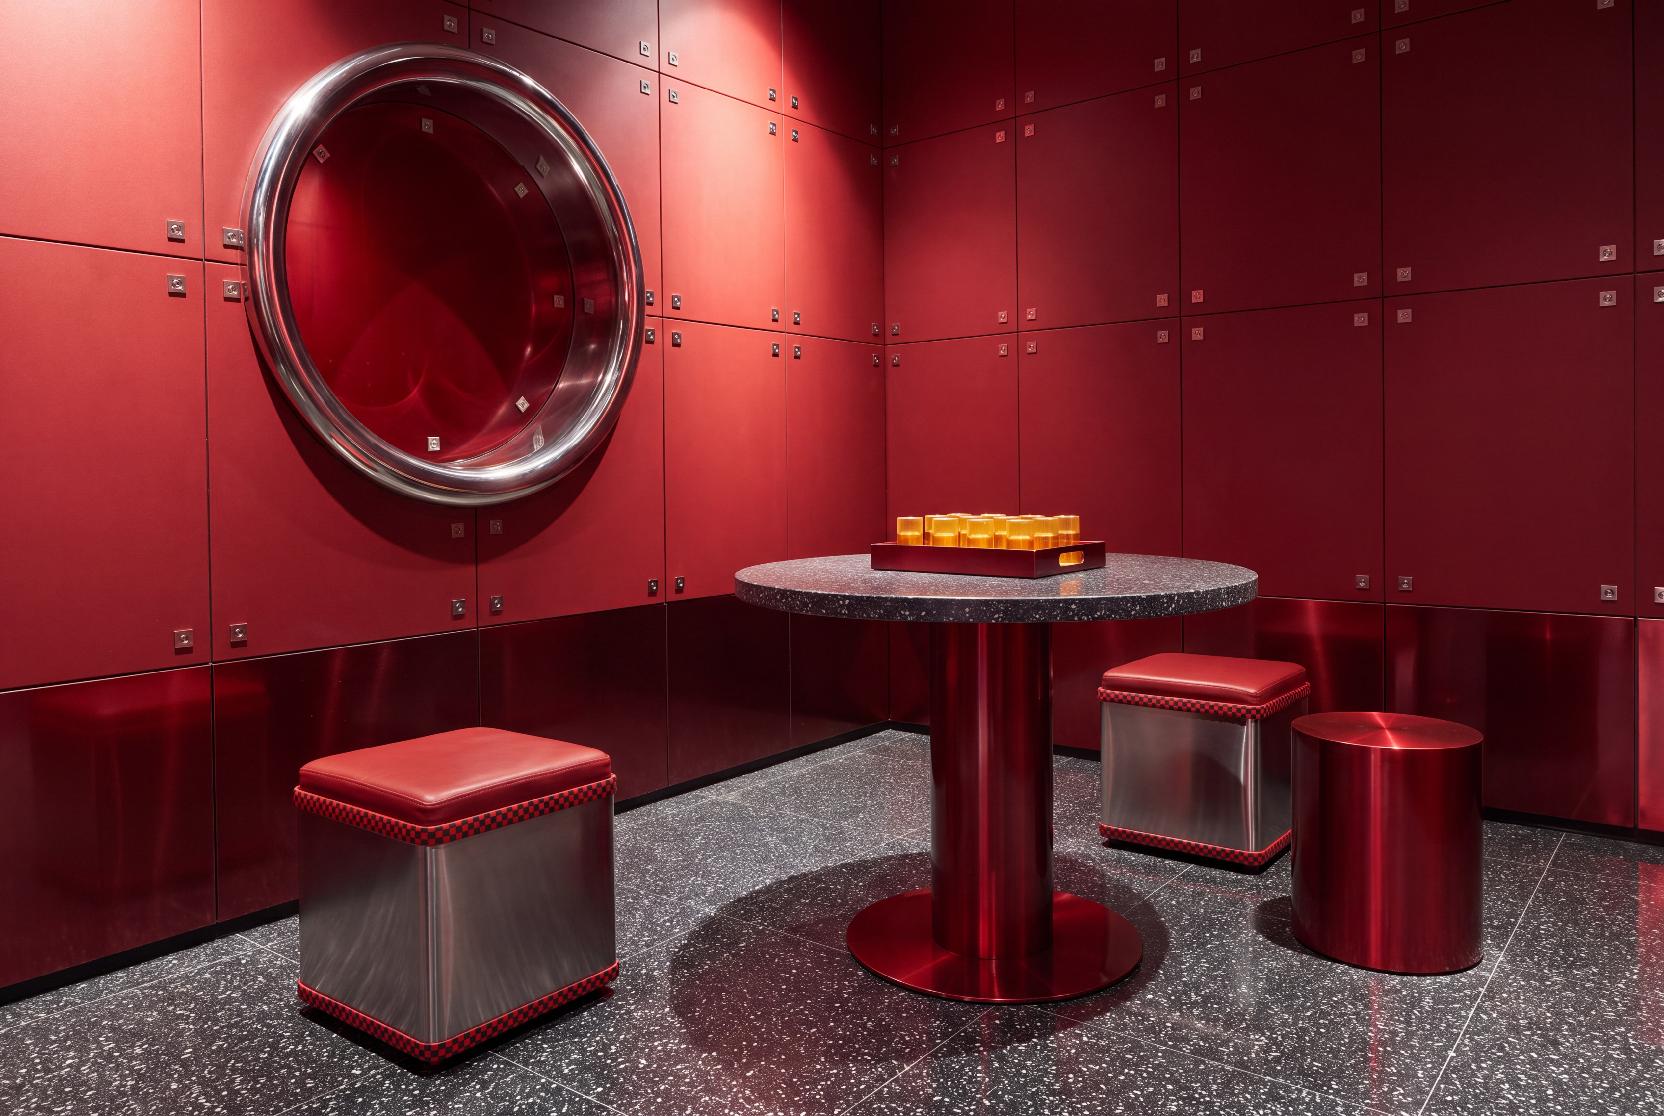
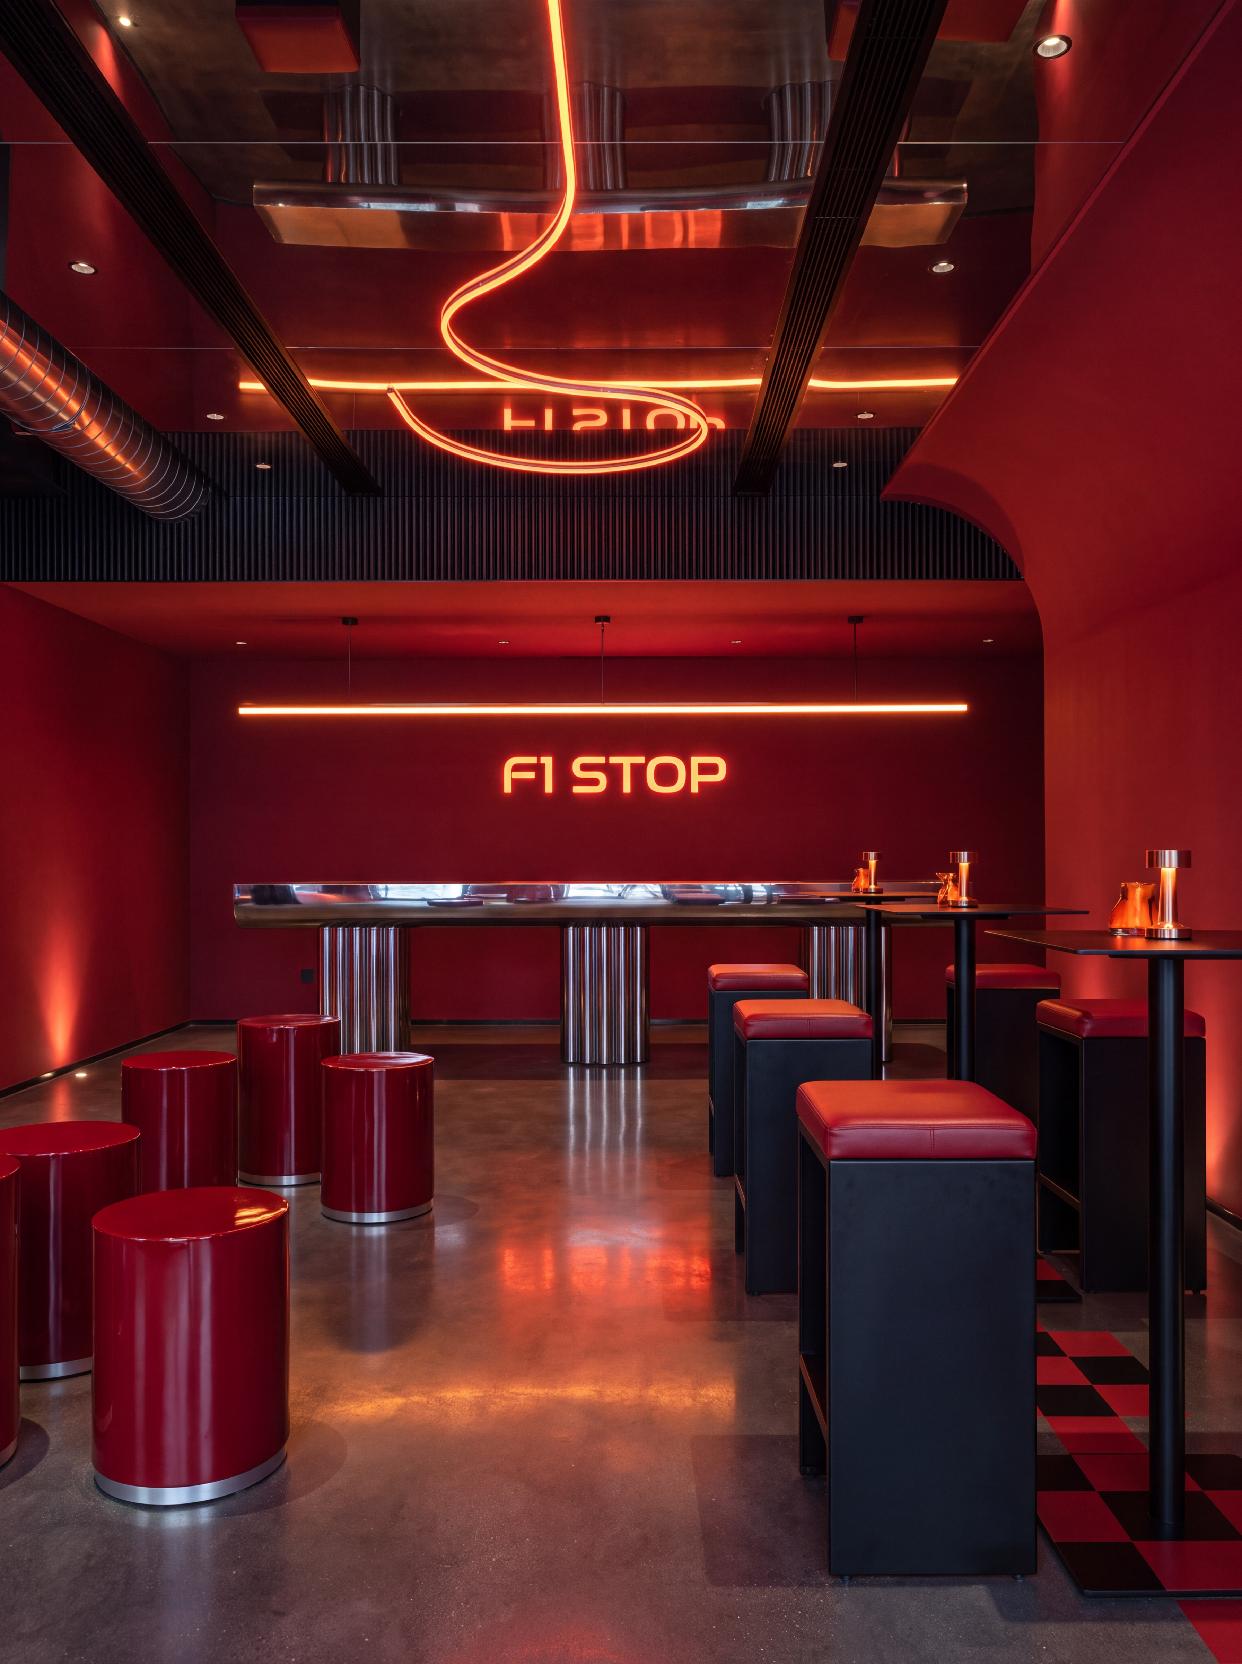
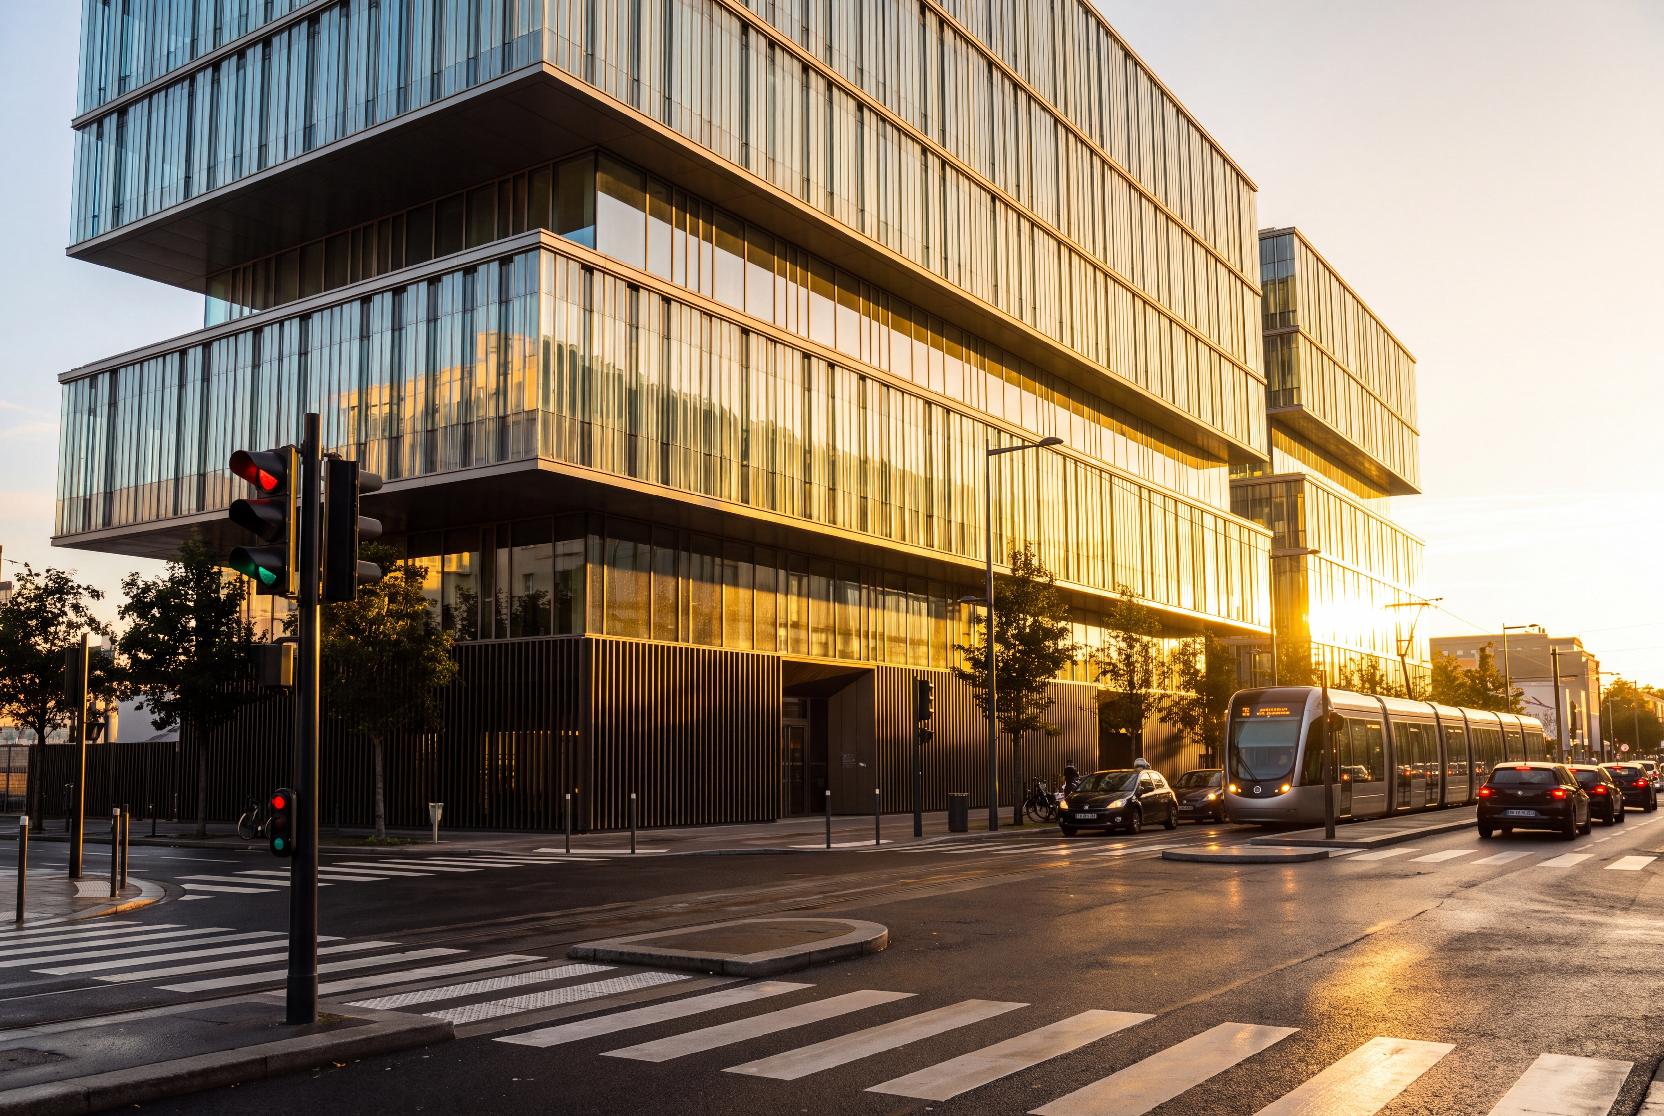
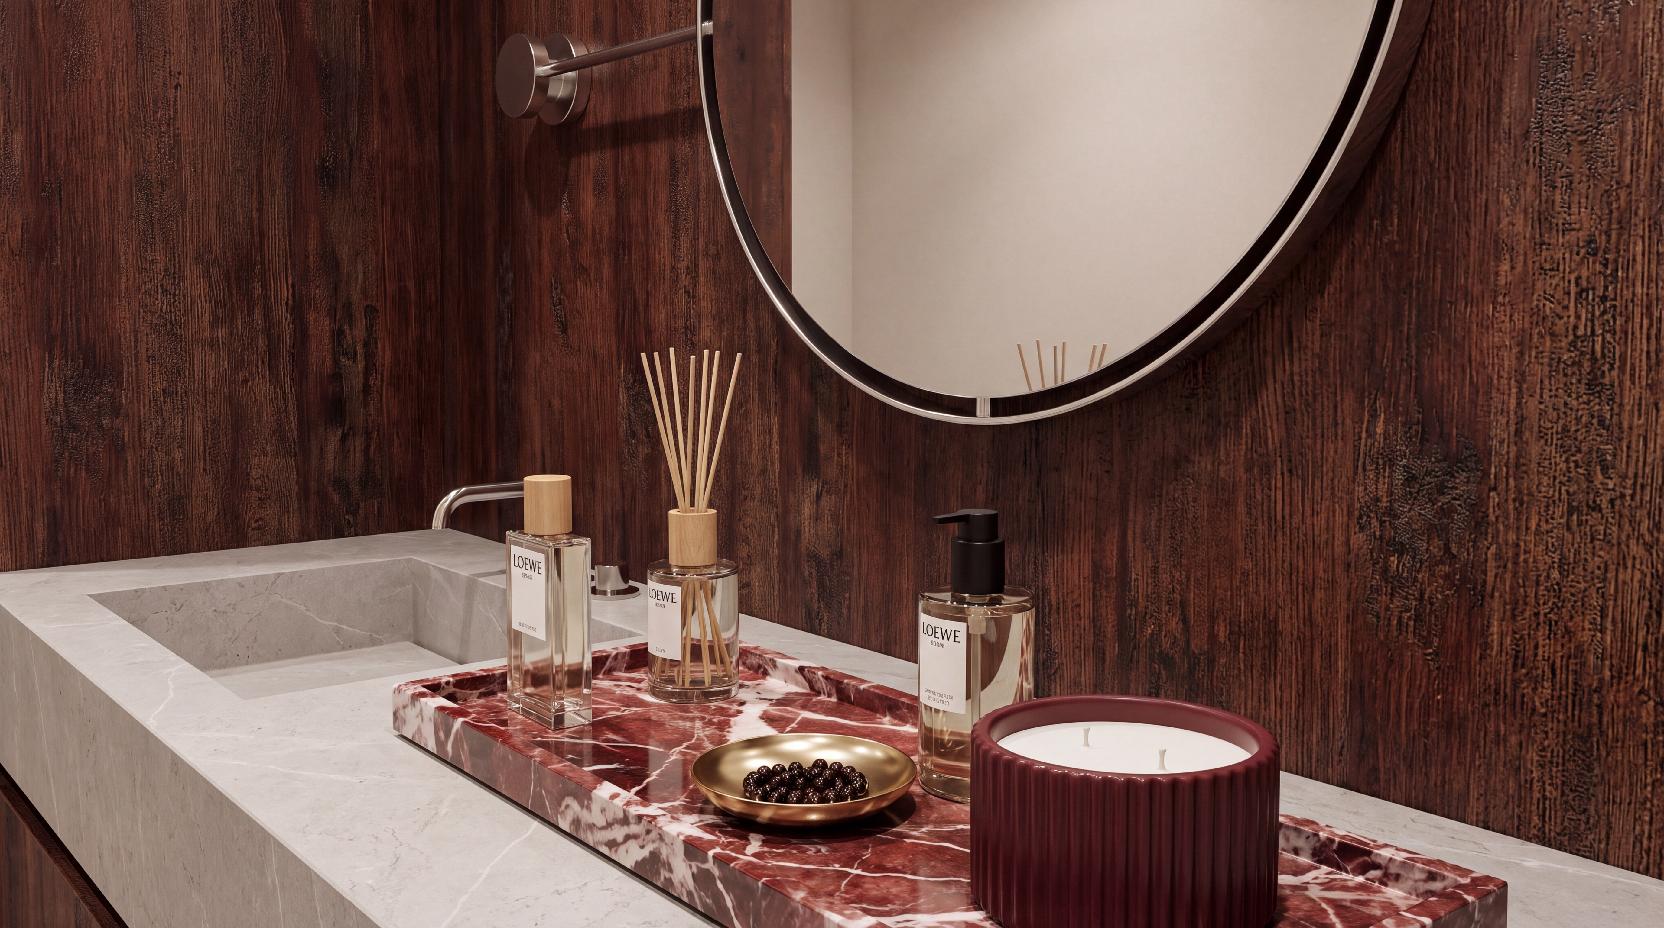
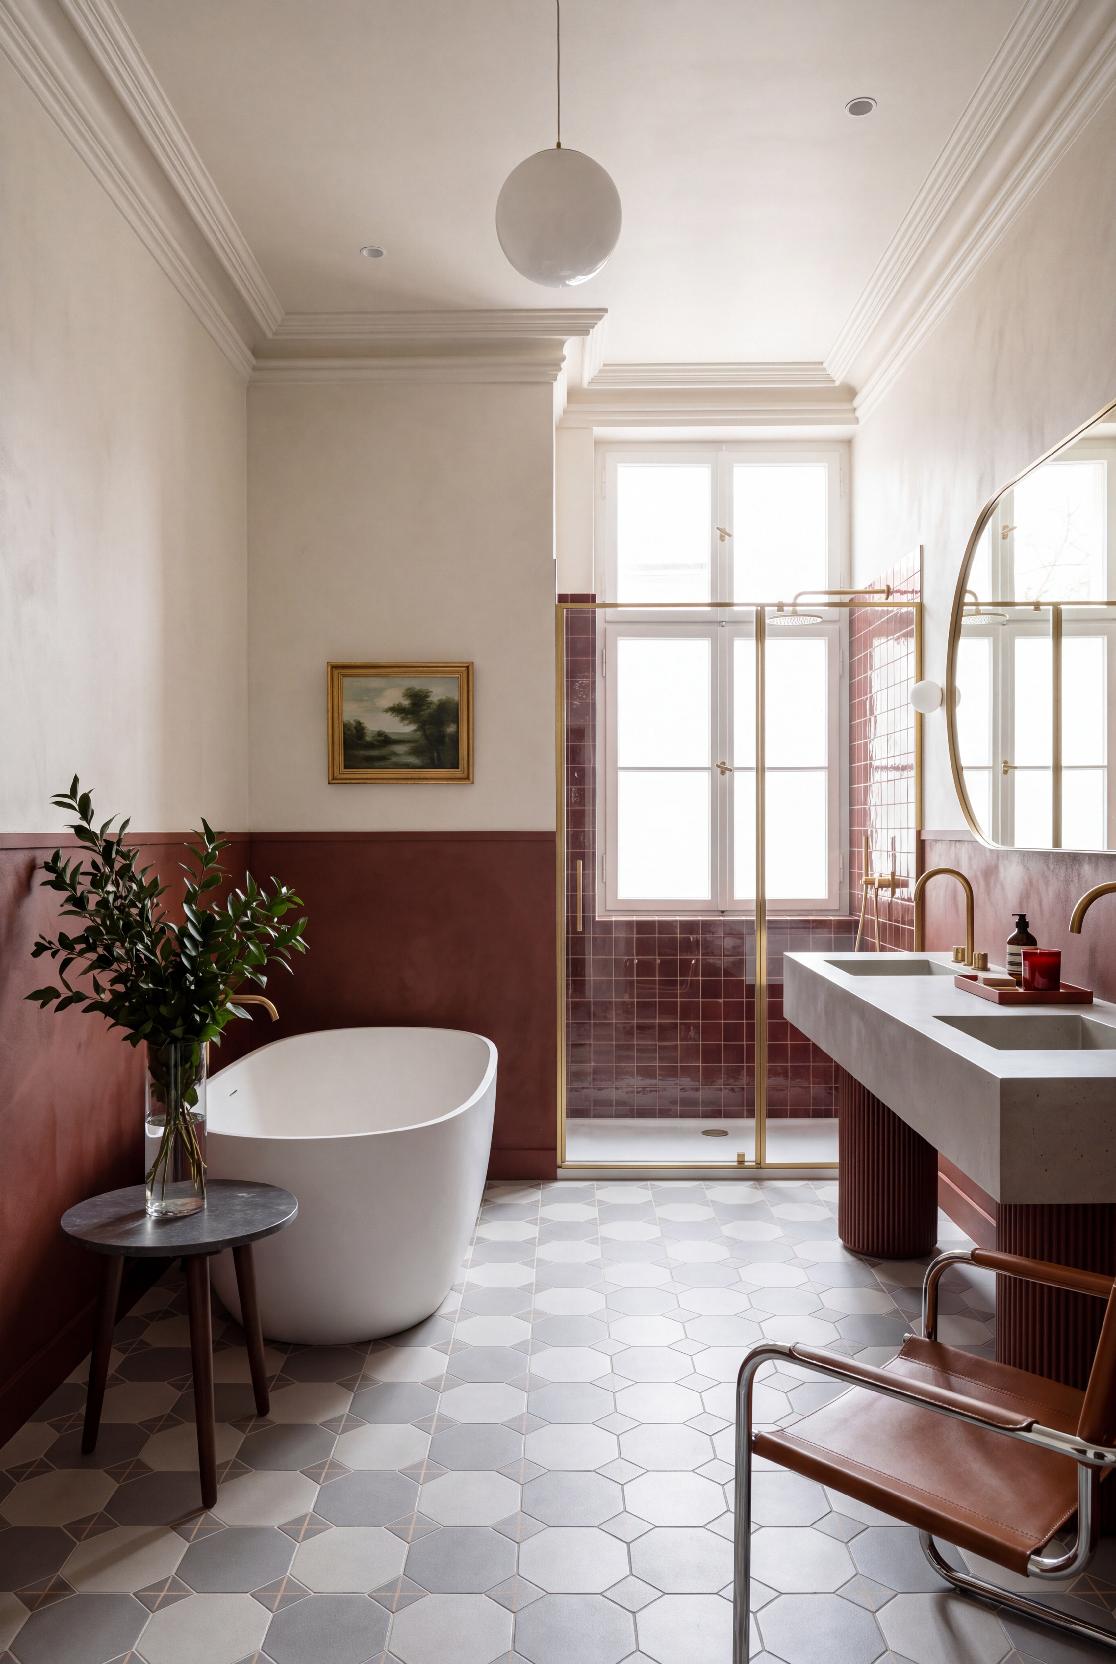
新画质更高、编辑更精准, 让空间构想清晰落地。用提示词和参考图推敲材质、灯光与家具, 局部修改时更好地保留原有构图和周边细节。从初步概念到精修方案呈现, 都能替换家具、调整饰面、尝试不同氛围 —— 帮设计师比较方案、打磨细节, 把完整的设计意图讲清楚。
30 积分
2K
7 张参考图
查看详情
新一代 AI 音视频生成模型, 面向高质量、更长篇幅的电影感内容创作…
向下了解更多
 视频模型
新一代 AI 音视频生成模型, 面向高质量、更长篇幅的电影感内容创作, 主体一致性、复杂运动、运镜控制、多镜头叙事与音画同步生成都有增强。
新一代 AI 音视频生成模型, 面向高质量、更长篇幅的电影感内容创作, 主体一致性、复杂运动、运镜控制、多镜头叙事与音画同步生成都有增强。
支持 480p 与 720p, 共 6 种画幅比例(21:9 到 9:16)。出图前先定画幅, 而不是事后裁切。
单条最长 30 秒, 并带音频。够拍一个镜头, 又短到可以反复试。
单次 20 积分, 通常约 1800 秒。运行前画布上就会标出这两项, 批量生成不会超出预期。
它在 Lovspark 里通常用来做这些 —— 每一项都是可以直接打开就跑的 AI 工作流。
使用步骤
从第一句提示词到可交付的视频, 四步。
Seedance2.5
第 1 步
在模型选择器里选 Seedance2.5。生成前就会标出积分与预计耗时。
最多挂 10 张参考图, 锁住主体、产品或风格 —— 不用全靠文字描述。
写清主体、构图、光线和氛围。该模型吃得下长提示词, 在 Lovspark 上写细一点更有回报。
横向比较各条, 把留下的那条直接送进画布的下一个节点 —— 不用重传、不用重描述。
新一代 AI 音视频生成模型, 面向高质量、更长篇幅的电影感内容创作, 主体一致性、复杂运动、运镜控制、多镜头叙事与音画同步生成都有增强。 它跑在 Lovspark 的视频生成器与节点画布里, 换成别的模型也不用重搭工作流。
单次 20 积分。生成前节点上就会显示, 批量生成按张数相乘。
480p 与 720p, 共 6 种画幅:21:9、16:9、4:3、1:1、3:4、9:16。
单次最长 30 秒, 含音频。
通常约 1800 秒, 取决于分辨率与排队情况。
同一块画布、同一套工作流 —— 换模型不用重搭。
画质更高、编辑更精准, 让空间构想清晰落地。用提示词和参考图推敲材质、灯光与家具, 局部修改时更好地保留原有构图和周边细节。从初步概念到精修方案呈现, 都能替换家具、调整饰面、尝试不同氛围 —— 帮设计师比较方案、打磨细节, 把完整的设计意图讲清楚。
GPT-2 Image(实际模型为 OpenAI 于 2026 年 4 月发布的 GPT-Image-2):首个带「思考」能力的图像生成模型。文字渲染准确率约 99%(此前为 90–95%), 最高支持 4096×4096 分辨率, 单次最多生成 8 张风格一致的图。思考模式内置推理与联网搜索。

Nano Banana Pro 是 Google 2025 年 11 月发布的 Gemini 3 Pro Image 模型。在 Lovspark 的 AI 图像生成器里, 它能把白模和总平面变成照片级效果图, 按一张风格参考图把毛坯空间装起来, 并在展板和平面图上排出清楚的文字, 最高 4K。

Seedream 5.0 Pro 是字节跳动最新的 AI 创作模型 —— 不只会出好看的图, 更懂设计。它能把原始数据和零散文字排成精致的信息图, 像 Photoshop 一样点选或圈选就能改任意局部, 光影与皮肤质感真实到让人多看两眼。原生支持十多种语言的文字渲染, 从英文到阿拉伯文都准确无误。告别开盲盒式生成, 新模型已在 Lovspark 上线。

Grok 的图像模型出图快、细节足、风格灵活, 适合快速产出高质量画面。
轻量快速版, 针对实时、高并发的图像生成任务优化, 延迟低。支持标准分辨率输出。